المحتويات
المقدمة
المناطق السحابية موثوقة بدرجة كبيرة، لكنها تتعطل مع ذلك. وعندما يحدث ذلك، يأتي الانقطاع غالبًا من اعتمادية مشتركة لا من توقف مركز بيانات كامل: مشكلة في DNS، أو خدمة هوية، أو لوحة تحكم ترفض التغييرات. والصمود أمام هذا النوع من الأحداث قرار هندسي يُتخذ قبل أشهر، ويبدأ بتحديد واضح لما يمكن للعمل تحمله.
ابدأ من RTO وRPO
هدف وقت التعافي (RTO) هو المدة التي يمكن أن تبقى فيها الخدمة غير متاحة. وهدف نقطة التعافي (RPO) هو مقدار البيانات الحديثة الذي يمكنك تحمل فقدانه. ويجب أن تحدد الإدارة كليهما لكل خدمة والتكلفة أمامها، لأن الانتقال من ساعات إلى دقائق يضاعف عادةً إنفاق البنية التحتية وتعقيد التشغيل.
- Tier 0، المسارات الحيوية للإيرادات: RTO بالدقائق وRPO قريب من الصفر.
- Tier 1، الخدمات الداخلية وخدمات العملاء المهمة: RTO خلال ساعة أو ساعتين وRPO بالدقائق.
- Tier 2، كل ما عدا ذلك: RTO خلال يوم، مع الاستعادة من النسخ الاحتياطية.
الأنماط الأربعة وموازناتها
- النسخ الاحتياطي والاستعادة: الخيار الأرخص. تُعاد البنية التحتية من الكود والبيانات من النسخ الاحتياطية. ويُقاس RTO بالساعات.
- Pilot light: تُنسخ البيانات باستمرار، وتوجد المكونات الأساسية في المنطقة الثانية دون سعة عاملة. ويعني التعافي توسيعها، عادةً خلال عشرات الدقائق.
- Warm standby: تعمل نسخة أصغر كاملة الوظائف في المنطقة الثانية وتتوسع أثناء التحويل. RTO بالدقائق.
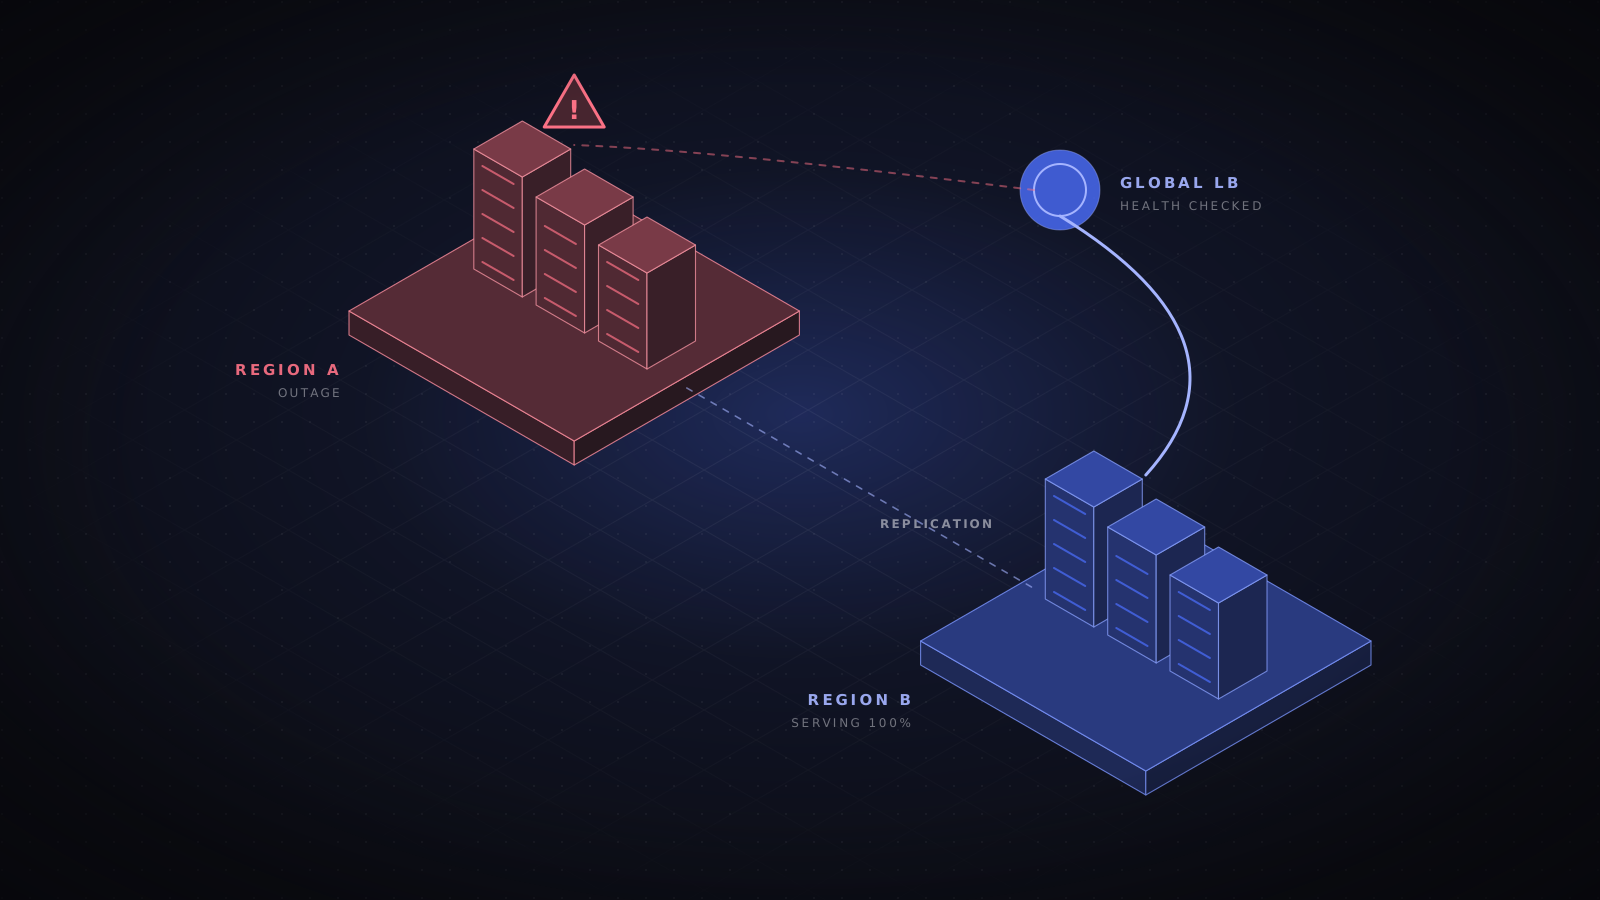
- Active-active: تخدم المنطقتان حركة الإنتاج طوال الوقت. والتحويل في معظمه نقل للحركة، لكن يجب أن يتحمل كل جزء من النظام العمل في مكانين في الوقت نفسه.
مشكلة البيانات خلف كل تحويل
يسهل تشغيل الخدمات عديمة الحالة في منطقتين، أما القرارات الصعبة فتتعلق بالبيانات. يضمن النسخ المتزامن بين المناطق عدم فقدان أي كتابة، لكن كل كتابة تتحمل حينها رحلة الذهاب والإياب بين المناطق، وهي محدودة بالفيزياء وتضيف غالبًا عشرات الميلي ثانية. ويبقي النسخ غير المتزامن الكتابة سريعة، لكن RPO لا يكون صفرًا حقًا أبدًا، فما لم يُنسخ عند تعطل المنطقة يضيع أو يجب تسويته لاحقًا.
تضيف الكتابة في نمط active-active حل التعارضات إلى القائمة. فقاعدة آخر كاتب يفوز بسيطة لكنها تتخلص من البيانات بصمت. وتعمل أنواع البيانات المنسوخة الخالية من التعارض جيدًا مع العدادات والمجموعات، لكن ليس مع كل كائن أعمال. وتقدم قواعد البيانات الموزعة عالميًا مثل Spanner وCockroachDB وAurora Global Database وجداول DynamoDB العالمية موازنات مختلفة بين الاتساق والتأخير والتكلفة، وتستحق قراءة متأنية قبل الالتزام. وأيًا كان اختيارك، اجعل عمليات الكتابة قابلة للتكرار دون أثر إضافي، كي لا تؤدي إعادة المحاولة أثناء التحويل إلى خصم المبلغ من العميل مرتين.
قلل نطاق الأثر بالخلايا
يحمي تعدد المناطق من فقدان منطقة، أما البنية القائمة على الخلايا فتحمي من عمليات النشر السيئة والطلبات المسمومة، وهي أكثر شيوعًا بكثير. يُقسم النظام إلى خلايا مستقلة، تخدم كل منها مجموعة من العملاء بنسخة خاصة من المنظومة. فلا يؤثر عطل، أو إصدار سيئ يُنشر خلية بعد خلية، إلا في عملاء تلك الخلية. ويذهب shuffle sharding أبعد من ذلك بمنح كل عميل مزيجًا مختلفًا من الموارد، فيقل احتمال أن يسقط عميل صاخب عميلًا آخر.
نقل الحركة عند الحاجة
- صمم للاستقرار الثابت: يجب ألا يعتمد التحويل على إنشاء موارد أو استدعاء لوحات التحكم في المنطقة المتعطلة. ويجب أن تكون السعة موجودة مسبقًا في المنطقة الاحتياطية.
- لا تعتمد على قيم TTL في DNS وحدها. فبعض العملاء والمحللات يحتفظون بالنتائج لمدة أطول مما تطلب. وتوفر موازنات الحمل العالمية أو anycast تحويلًا أسرع وأكثر توقعًا.
- يجب أن تختبر فحوص السلامة الاعتماديات الحقيقية، لكن تجنب أن يؤدي فشل اعتمادية مشتركة واحدة إلى فشل كل الفحوص معًا وإفراغ المنطقتين.
- حدد مسبقًا من يملك صلاحية التحويل ومدى كون القرار يدويًا. فالتحويل التلقائي بناءً على إشارة متذبذبة قد يسبب ضررًا أكبر من الانقطاع الأصلي.
أثبت ذلك قبل أن تحتاج إليه
نفذ أيام تمرين تحوّل فيها خدمة إنتاج عمدًا، خلال ساعات العمل، مع الأشخاص الذين سيكونون مناوبين. واستخدم أدوات حقن الأعطال مثل AWS Fault Injection Service أو Azure Chaos Studio أو Chaos Mesh للتدرب باستمرار على أعطال أصغر. سجل وقت التعافي الفعلي وفقدان البيانات في كل مرة، وقارنهما بالأهداف التي وعدت بها. فالفجوة بينهما هي خارطة طريق الصمود لديك.
الخاتمة
الانقطاع الإقليمي نادر، لكن القرارات التي تحدد كيفية التعامل معه تُتخذ قبل وقوعه بوقت طويل. حدد RTO وRPO لكل خدمة، واختر أبسط نمط يحققهما، وخطط لانتقال البيانات، واختبر التحويل بانتظام. فنتائج الاختبارات الحقيقية وحدها تثبت أن الخطة تعمل.
- الصمود
- التعافي من الكوارث
- تعدد المناطق
- البنية