Sommaire
Introduction
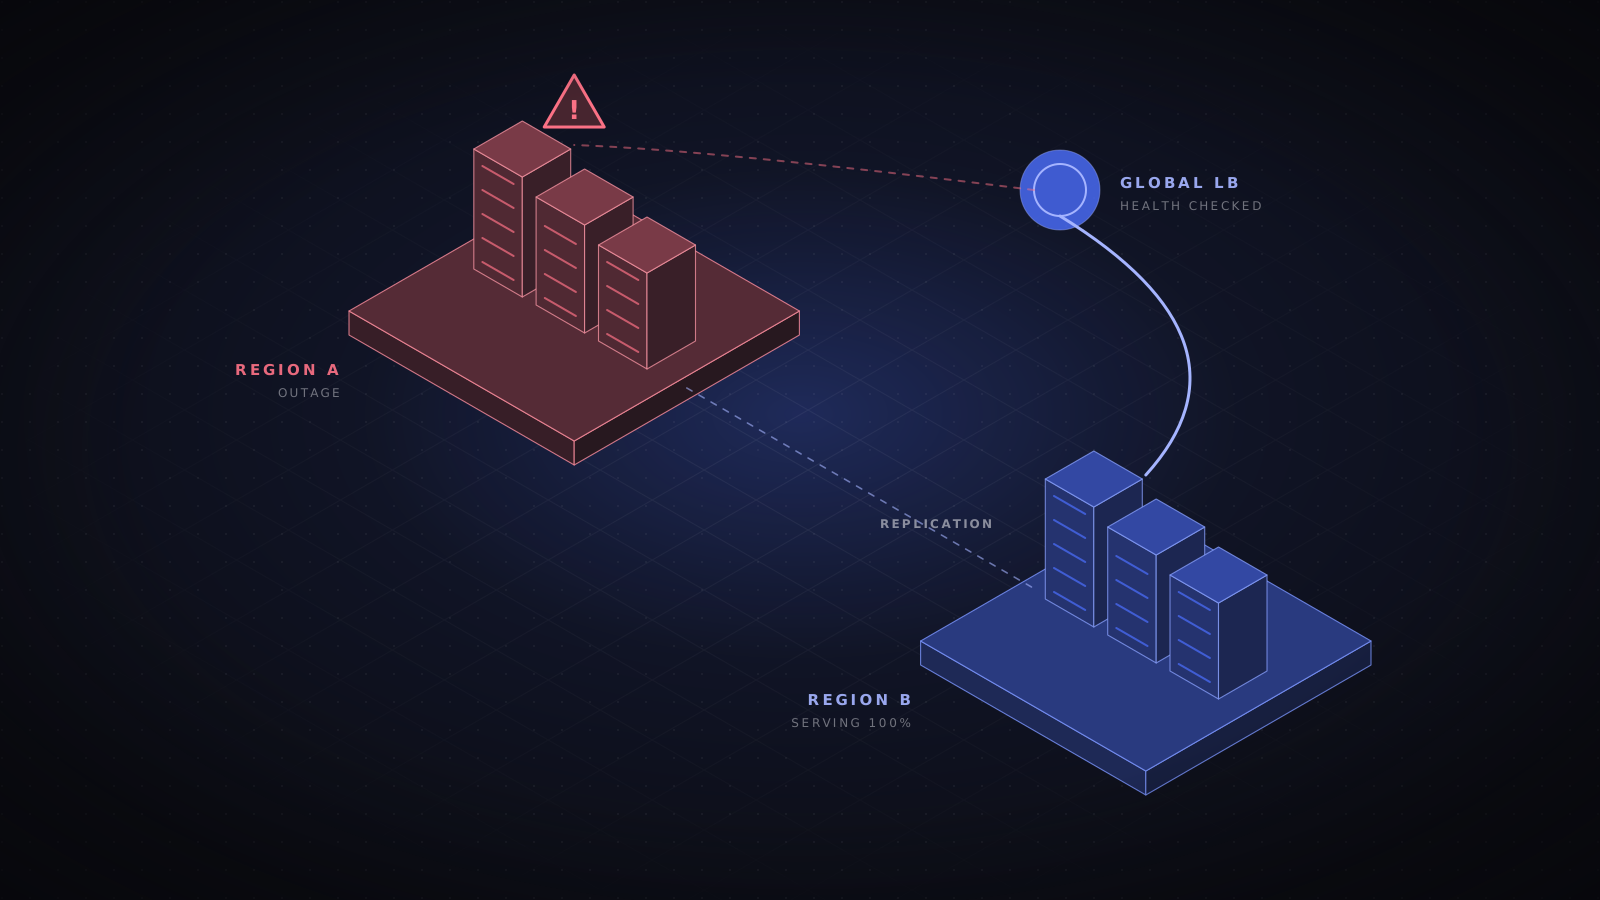
Les régions cloud sont remarquablement fiables, mais elles tombent quand même en panne. Lorsque cela arrive, la panne vient souvent d’une dépendance partagée plutôt que de l’arrêt d’un data center entier : un problème DNS, un service d’identité, un plan de contrôle qui refuse les changements. Survivre à ce type d’événement est une décision d’architecture prise des mois plus tôt, et elle commence par une définition claire de ce que l’entreprise peut tolérer.
Partez du RTO et du RPO
L’objectif de temps de reprise (RTO) est la durée pendant laquelle un service peut rester indisponible. L’objectif de point de reprise (RPO) est la quantité de données récentes que vous pouvez vous permettre de perdre. Les deux doivent être fixés par service, par l’entreprise, en ayant le coût sous les yeux, car passer de quelques heures à quelques minutes multiplie en général les dépenses d’infrastructure et la complexité d’exploitation.
- Tier 0, parcours critiques pour le chiffre d’affaires : RTO en minutes, RPO proche de zéro.
- Tier 1, services internes et clients importants : RTO d’une ou deux heures, RPO de quelques minutes.
- Tier 2, tout le reste : RTO d’une journée, restauration depuis les sauvegardes.
Les quatre modèles et leurs compromis
- Sauvegarde et restauration : l’option la moins chère. L’infrastructure est recréée à partir du code et les données à partir des sauvegardes. Le RTO se mesure en heures.
- Pilot light : les données sont répliquées en continu et les composants essentiels existent dans la seconde région, mais sans capacité active. La reprise consiste à monter en charge, généralement en quelques dizaines de minutes.
- Warm standby : une copie plus petite et pleinement fonctionnelle tourne dans la seconde région et monte en charge lors du basculement. RTO de quelques minutes.
- Actif-actif : les deux régions servent le trafic de production en permanence. Le basculement est surtout un déplacement de trafic, mais chaque partie du système doit pouvoir fonctionner à deux endroits à la fois.
Le problème des données derrière chaque basculement
Les services sans état sont faciles à exécuter dans deux régions. Les décisions difficiles concernent les données. La réplication synchrone entre régions garantit qu’aucune écriture n’est perdue, mais chaque écriture paie alors l’aller-retour entre régions, limité par la physique et ajoutant souvent des dizaines de millisecondes. La réplication asynchrone garde des écritures rapides, mais le RPO n’est alors jamais vraiment nul : tout ce qui n’est pas encore répliqué au moment de la panne est perdu ou doit être rapproché plus tard.
Les écritures actif-actif ajoutent la résolution des conflits. La règle du dernier écrivain est simple, mais elle supprime des données en silence. Les types de données répliqués sans conflit conviennent aux compteurs et aux ensembles, mais pas à tous les objets métier. Les bases distribuées mondialement comme Spanner, CockroachDB, Aurora Global Database et les tables globales DynamoDB font chacune des compromis différents entre cohérence, latence et coût, qui méritent une lecture attentive avant de vous engager. Quel que soit votre choix, rendez les écritures idempotentes pour que les nouvelles tentatives pendant un basculement ne puissent pas facturer un client deux fois.
Limitez le rayon d’impact avec des cellules
Le multirégion protège contre la perte d’une région. L’architecture par cellules protège contre vos propres mauvais déploiements et requêtes empoisonnées, bien plus fréquents. Le système est divisé en cellules indépendantes, chacune servant une partie des clients avec sa propre copie de la pile. Une panne, ou une mauvaise version déployée cellule par cellule, ne touche que les clients de cette cellule. Le shuffle sharding pousse l’idée plus loin en attribuant à chaque client une combinaison différente de ressources, pour qu’un client trop bruyant ait peu de chances d’en faire tomber un autre.
Déplacer le trafic au moment critique
- Concevez pour la stabilité statique : le basculement ne doit pas dépendre de la création de ressources ni d’appels aux plans de contrôle de la région en panne. La capacité doit déjà exister dans la région de secours.
- Ne comptez pas uniquement sur les TTL DNS. Certains clients et résolveurs gardent les réponses en cache plus longtemps que demandé. Les répartiteurs de charge mondiaux ou l’anycast offrent des bascules plus rapides et plus prévisibles.
- Les contrôles de santé doivent tester les vraies dépendances, mais évitez qu’une seule dépendance partagée fasse échouer tous les contrôles à la fois et vide les deux régions.
- Décidez à l’avance qui a le pouvoir de basculer et à quel point cette décision est manuelle. Un basculement automatique sur un signal instable peut causer plus de dégâts que la panne d’origine.
Prouvez-le avant d’en avoir besoin
Organisez des exercices où vous basculez volontairement un service de production, pendant les heures de travail, avec les personnes qui seraient d’astreinte. Utilisez des outils d’injection de pannes comme AWS Fault Injection Service, Azure Chaos Studio ou Chaos Mesh pour répéter en continu des pannes plus petites. Notez à chaque fois le temps de reprise réel et la perte de données, puis comparez-les aux objectifs promis. L’écart entre les deux constitue votre feuille de route de résilience.
Conclusion
Une panne régionale est rare, mais les décisions qui déterminent sa gestion sont prises bien avant qu’elle survienne. Fixez un RTO et un RPO pour chaque service, choisissez le modèle le plus simple qui les atteint, planifiez le déplacement des données et testez régulièrement le basculement. Seuls les résultats de vrais tests montrent que le plan fonctionne.
- Résilience
- Reprise après sinistre
- Multirégion
- Architecture