Sommaire
Introduction
La surveillance vous dit qu’un problème prévu est survenu. L’observabilité permet d’enquêter sur des pannes que vous n’aviez pas prévues, ce qui, dans un système de dizaines de services, représente la plupart d’entre elles. La différence tient aux données collectées, à la façon dont elles sont reliées et à votre rigueur sur ce qui devient une alerte.
Standardisez avec OpenTelemetry
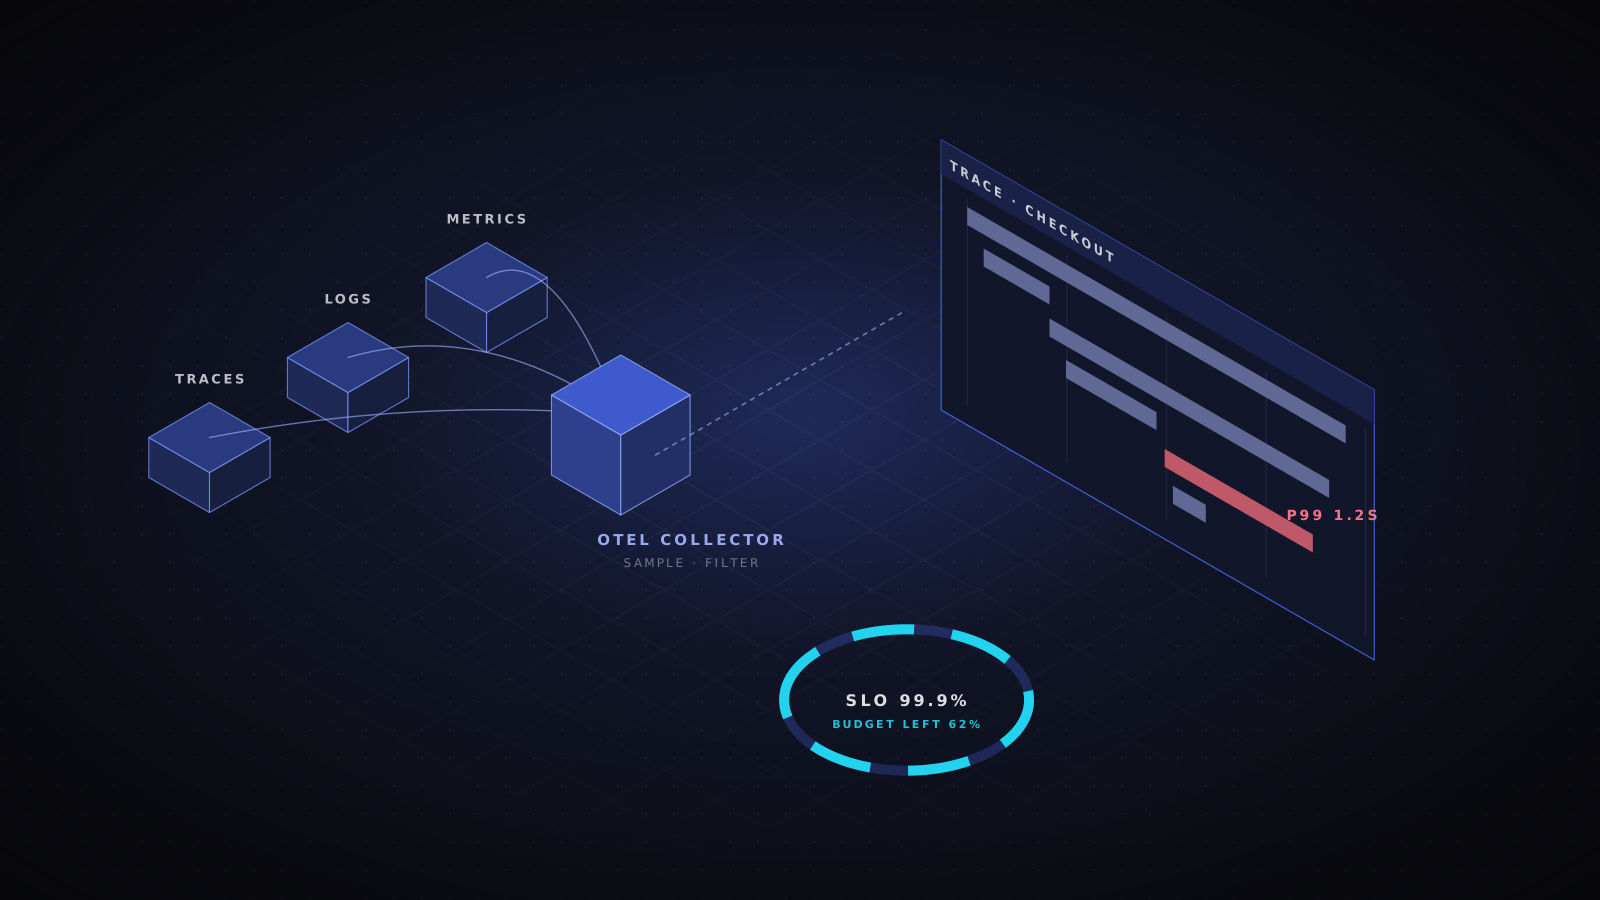
OpenTelemetry est la norme de la CNCF pour produire et transmettre traces, métriques et journaux. Il fournit des API et SDK indépendants des éditeurs, une instrumentation automatique pour les frameworks courants et le Collector, un pipeline qui reçoit, traite et exporte la télémétrie. L’intérêt concret est simple : vous instrumentez votre code une fois et gardez la liberté de changer de backend sans toucher au code applicatif.
Deux détails distinguent de belles traces de traces utiles. D’abord, propagez le contexte à chaque saut avec les en-têtes W3C Trace Context, y compris dans les files de messages, où on l’oublie le plus souvent. Ensuite, suivez les conventions sémantiques pour les noms d’attributs, afin que http.response.status_code ait le même sens dans chaque service et chaque requête.
Échantillonnez à dessein
Conserver toutes les traces coûte rarement moins que ce qu’elles rapportent à grande échelle, et la plupart des requêtes réussies se ressemblent. L’échantillonnage en tête décide au début de la requête et coûte peu, mais il écarte les rares erreurs qui vous intéressent. L’échantillonnage en queue décide après avoir vu toute la trace : vous gardez alors chaque erreur et chaque requête lente, et vous échantillonnez le trafic courant.
receivers:
  otlp:
    protocols:
      grpc: {}
      http: {}
processors:
  tail_sampling:
    decision_wait: 10s
    policies:
      - name: keep-errors
        type: status_code
        status_code: { status_codes: [ERROR] }
      - name: keep-slow
        type: latency
        latency: { threshold_ms: 500 }
      - name: sample-the-rest
        type: probabilistic
        probabilistic: { sampling_percentage: 5 }
  batch: {}
exporters:
  otlp:
    endpoint: tracing-backend:4317
service:
  pipelines:
    traces:
      receivers: [otlp]
      processors: [tail_sampling, batch]
      exporters: [otlp]
L’échantillonnage en queue exige que tous les spans d’une trace atteignent la même instance du Collector. Dans une architecture horizontale, placez en amont un premier niveau de Collectors avec l’exportateur de répartition de charge fondé sur l’ID de trace.
Maîtrisez les coûts de télémétrie
- Surveillez la cardinalité des métriques. Un label contenant des ID d’utilisateur, des ID de requête ou des URL complètes peut multiplier vos séries temporelles par millions. Gardez ces valeurs dans les traces et les journaux, où elles ont leur place.
- Supprimez, filtrez et agrégez dans le Collector avant que les données n’atteignent un backend payant. L’octet le moins cher est celui que vous n’envoyez jamais.
- Fixez les niveaux de journalisation par environnement et traitez le mode debug en production comme une exception temporaire et limitée dans le temps.
- Utilisez des exemplars pour relier directement un pic de latence sur une métrique à des traces d’exemple, plutôt que de conserver toutes les traces pour en trouver une.
Laissez les SLO décider de ce qui compte
Un objectif de niveau de service indique la fiabilité nécessaire du point de vue de l’utilisateur, par exemple « 99,9 % des requêtes de paiement réussissent en moins de 800 ms sur 28 jours ». L’indicateur est le rapport entre les événements réussis et les événements valides. Les 0,1 % restants forment le budget d’erreur, soit environ 40 minutes de panne totale sur 28 jours, et il offre au produit et à l’ingénierie un moyen chiffré et partagé d’arbitrer entre fiabilité et fonctionnalités.
Alertez sur la vitesse de consommation du budget plutôt que sur des seuils bruts. L’approche à plusieurs fenêtres et plusieurs taux décrite dans le Google SRE Workbook n’alerte un humain que lorsque le budget disparaît vite. Sur une fenêtre de 30 jours, un taux de 14,4 maintenu pendant une heure consomme 2 % du budget, ce qui est assez grave pour réveiller quelqu’un. Les consommations plus lentes ouvrent plutôt un ticket.
De l’alerte à la cause première
Un bon chemin d’enquête est court et reproductible. L’alerte de consommation du SLO renvoie à un tableau de bord du débit, des erreurs et de la durée du service touché. Un exemplar sur le panneau de latence ouvre une trace lente. La trace montre quel appel en aval est responsable, et son ID retrouve les lignes de journal exactes de cette requête. Pour les composants que vous ne pouvez pas instrumenter directement, les outils fondés sur eBPF peuvent capturer le comportement réseau et d’exécution depuis le noyau, sans changer le code.
Conclusion
Lorsque le chemin de l’alerte à la cause première prend quelques minutes au lieu d’un après-midi, les incidents raccourcissent et l’astreinte devient plus calme. C’est ce résultat, et non le nombre de tableaux de bord, qui mesure un programme d’observabilité.
- Observabilité
- OpenTelemetry
- SLO
- SRE