Sommaire
Introduction
Les plateformes internes échouent rarement par une panne. Elles échouent lentement, à mesure que les équipes reviennent à leurs propres scripts parce que la voie officielle est plus lente que le contournement. Kubernetes a rendu le problème plus visible. Il offre une énorme souplesse, puis attend de chaque équipe produit qu’elle maîtrise les manifestes, les contrôleurs d’ingress, les politiques réseau et l’autoscaling. Le rôle d’une équipe plateforme est d’absorber cette complexité une fois, pour que les autres équipes n’aient pas à le faire vingt fois.
Gérez la plateforme comme un produit
Les développeurs qui utilisent votre plateforme sont ses clients, et ils peuvent refuser d’acheter sans bruit. Les équipes qui réussissent traitent la plateforme comme un produit, avec une feuille de route, un backlog issu des difficultés réelles et une personne chargée de parler aux utilisateurs chaque semaine.
- Suivez une équipe pendant son premier déploiement et notez chaque moment où elle a dû demander de l’aide ou attendre un ticket.
- Tenez une feuille de route publique et un journal des modifications. Les changements qui surprennent érodent la confiance plus vite que les fonctions manquantes.
- Mesurez l’adoption, pas la disponibilité. Une plateforme à cinq neuf et trois utilisateurs est un projet raté.
Des parcours recommandés, avec une sortie
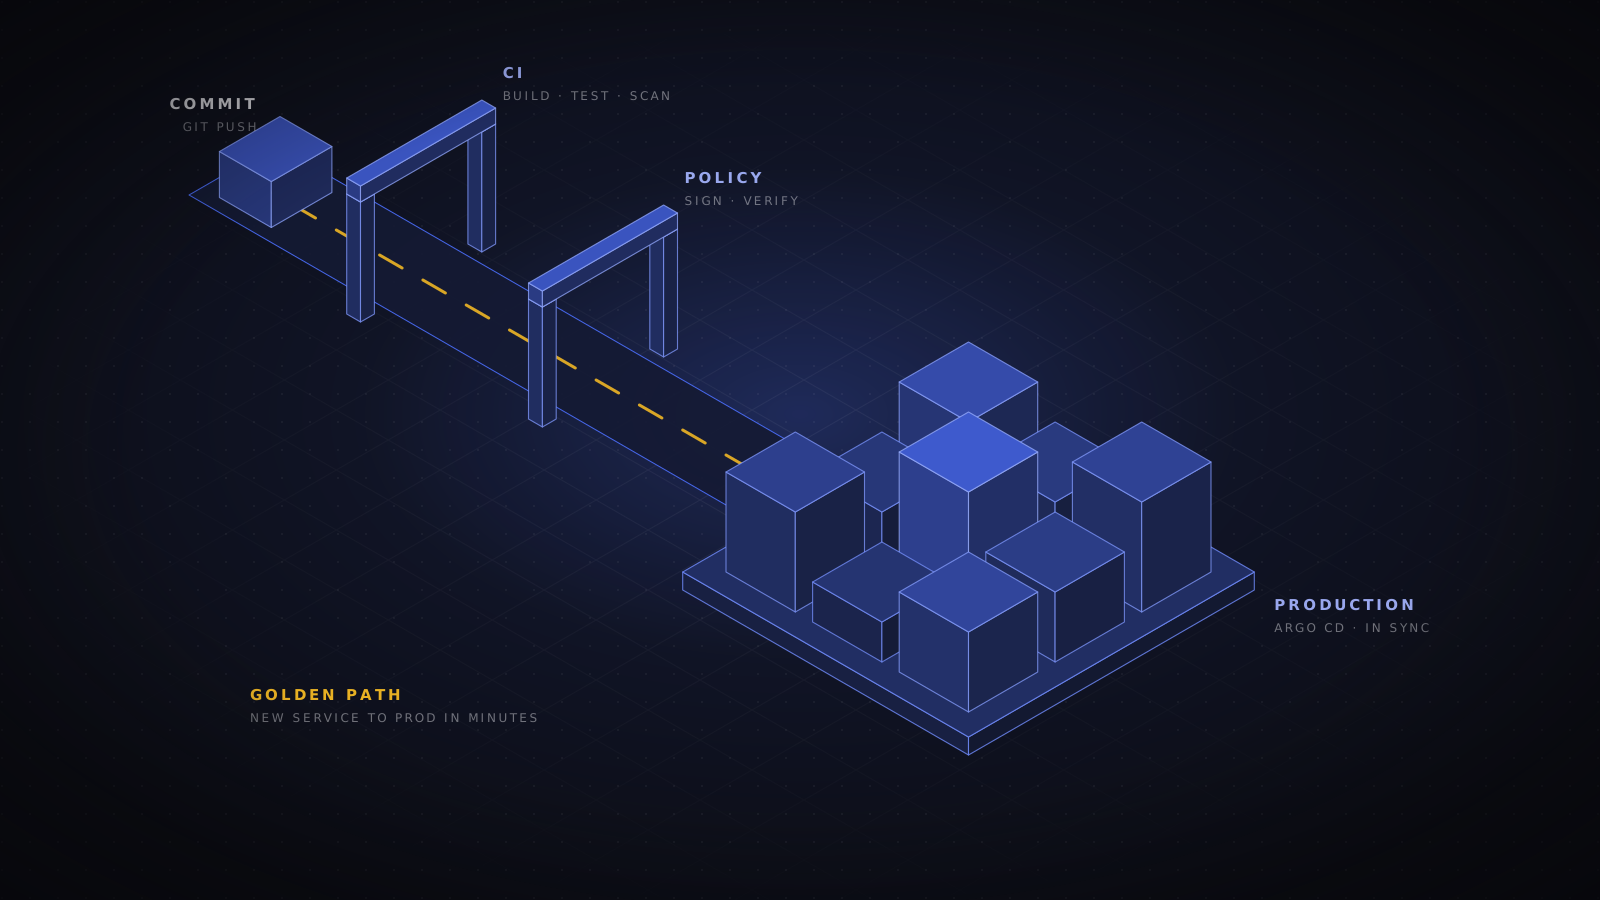
Un parcours recommandé est la voie prise en charge et balisée pour une tâche courante : créer un service, ajouter une base de données, exposer une API. Bien conçu, il livre un nouveau service en quelques minutes avec un dépôt, un pipeline CI, une construction de conteneur, des manifestes de déploiement, des tableaux de bord, des alertes et un SLO par défaut déjà branchés. Backstage, le portail développeurs de la CNCF, est un moyen courant de proposer ces modèles avec un catalogue logiciel qui montre qui possède quoi.
Les équipes doivent pouvoir quitter ce parcours lorsqu’elles ont une bonne raison. Si la seule sortie est un ticket à l’équipe plateforme, les gens vous contourneront. Le parcours doit simplement être, de loin, l’option la plus facile.
GitOps comme colonne vertébrale de la livraison
Avec GitOps, l’état souhaité de chaque environnement se trouve dans Git, et un contrôleur comme Argo CD ou Flux aligne en permanence le cluster sur cet état. Les déploiements deviennent des pull requests, les retours arrière des annulations, et les dérives sont détectées et corrigées automatiquement. La promotion entre environnements est un changement de fichier traçable, et non une suite de commandes lancées depuis un portable.
apiVersion: argoproj.io/v1alpha1
kind: Application
metadata:
  name: orders-api
  namespace: argocd
spec:
  project: default
  source:
    repoURL: https://git.example.com/platform/deployments.git
    targetRevision: main
    path: apps/orders-api/overlays/production
  destination:
    server: https://kubernetes.default.svc
    namespace: orders
  syncPolicy:
    automated:
      prune: true
      selfHeal: true
Gardez les secrets hors du dépôt. Un opérateur de secrets externes qui les récupère à l’exécution dans un coffre ou un gestionnaire de secrets cloud est plus propre, et changer un identifiant n’exige alors jamais de commit.
Des garde-fous plutôt que des barrières
Les files d’approbation manuelle sont le pire ennemi de l’expérience développeur. Remplacez-les par des politiques automatisées, exécutées dans le pipeline et à l’admission dans le cluster, avec des outils comme OPA Gatekeeper ou Kyverno. Les garde-fous typiques rejettent les conteneurs privilégiés, exigent des requêtes et limites de ressources, n’autorisent que les images signées dans votre pipeline (par exemple avec Sigstore cosign) et bloquent les répartiteurs de charge publics hors des espaces de noms approuvés.
La qualité du message d’erreur compte autant que la règle. « Refusé par la politique » envoie quelqu’un sur Slack. « Les conteneurs de production doivent avoir des limites de mémoire ; ajoutez resources.limits.memory, voir le modèle de service pour les valeurs par défaut » permet de corriger et d’avancer.
Choisissez le bon niveau d’abstraction
Si vous cachez trop peu, chaque équipe a encore besoin d’un expert Kubernetes. Si vous cachez trop, la première exigence inhabituelle casse l’abstraction. Un modèle efficace est une courte description du service tenue par l’équipe produit (image, ports, limites de mise à l’échelle, dépendances, SLO), que la plateforme développe en l’ensemble complet de manifestes. Les équipes qui ont besoin de plus peuvent descendre d’un niveau pour un seul service sans dupliquer toute la plateforme.
Prouver que cela fonctionne
- Les quatre indicateurs DORA : fréquence de déploiement, délai de mise en production des changements, taux d’échec des changements et délai de rétablissement, mesurés par équipe et suivis par trimestre.
- Le temps entre « nouveau service » et le premier déploiement en production. Ce chiffre révèle chaque étape manuelle cachée.
- La part des services sur le parcours recommandé et les raisons données par les équipes pour le quitter.
- Une courte enquête de satisfaction des développeurs chaque trimestre, avec des réponses libres que quelqu’un lit vraiment.
Conclusion
L’ingénierie de plateforme est rentable lorsqu’elle fait de la bonne façon de construire un logiciel la plus rapide. La sécurité, la fiabilité et la maîtrise des coûts viennent alors gratuitement, car elles sont intégrées au chemin que tout le monde emprunte déjà.
- Ingénierie de plateforme
- Kubernetes
- GitOps
- Expérience développeur