Sommaire
Introduction
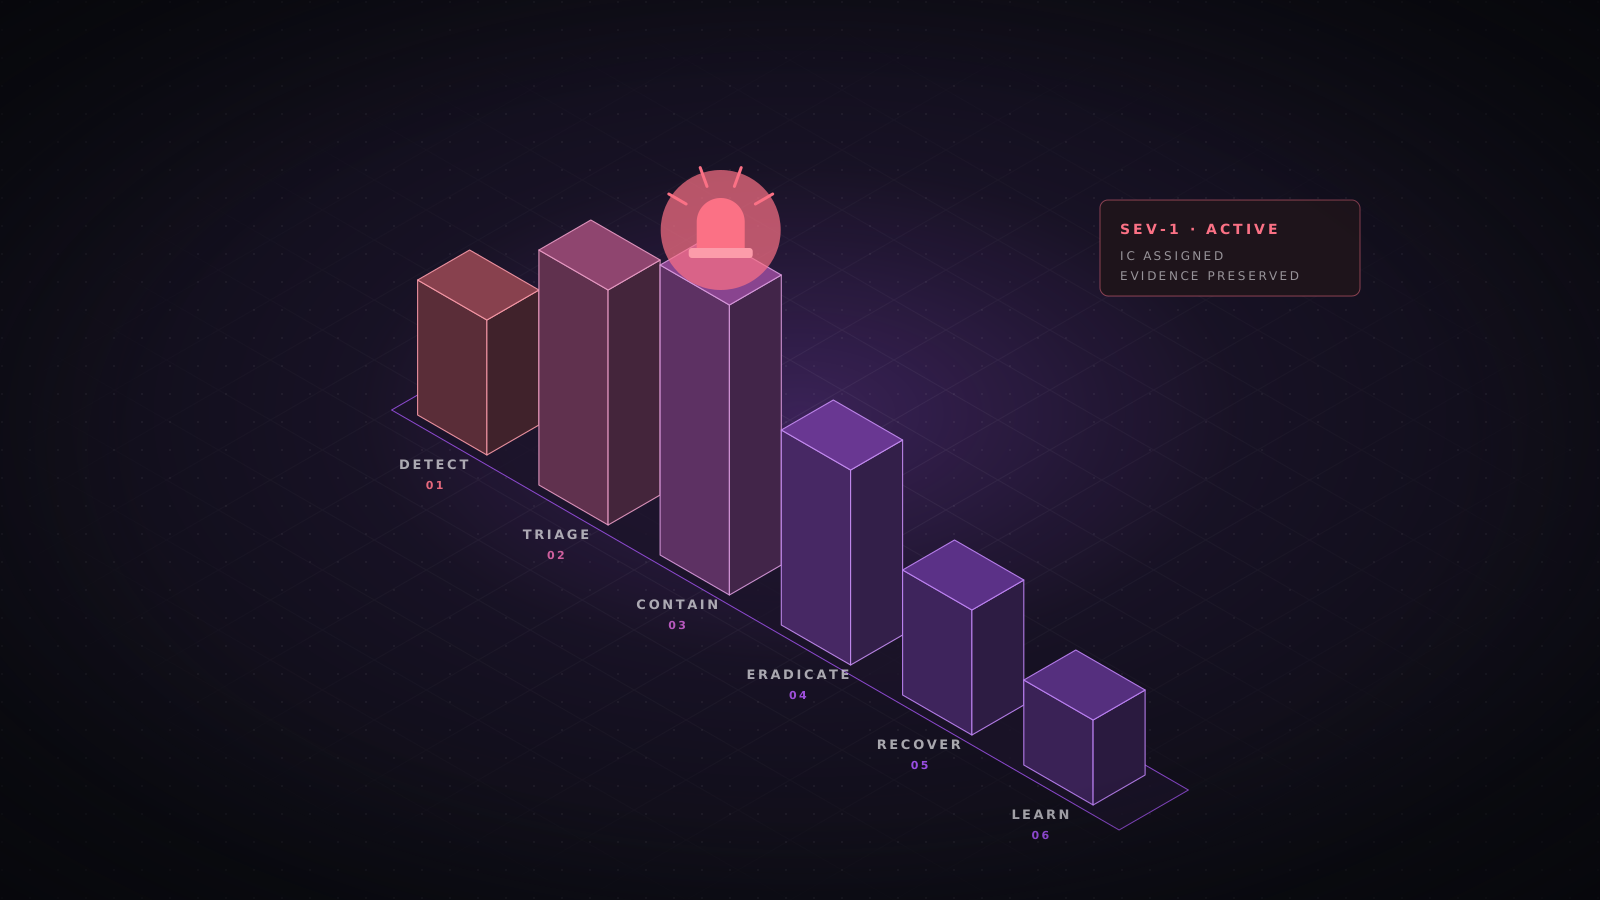
La plupart des incidents se gagnent ou se perdent dans la première heure. Les intervenants expérimentés contiennent l’attaquant sans détruire les preuves, sans l’alerter et sans faire payer à l’entreprise plus que nécessaire. Ce guide résume notre façon de mener cette heure et tout ce qui suit. Il suit le cycle de vie décrit par le NIST dans la SP 800-61, qui relie désormais la réponse à incident aux fonctions Detect, Respond et Recover du Cybersecurity Framework 2.0.
Préparation : décidée avant l’incident
Rien sur cette liste ne s’improvise sous pression. Si cela n’existe pas un mardi tranquille, cela n’existera pas à 3 h du matin.
- Autorité de décision : qui peut isoler la production, mettre des systèmes hors ligne et faire appel à un conseil externe, sans attendre une réunion.
- Un canal hors bande : partez du principe que la messagerie, le chat et le fournisseur d’identité sont compromis. Gardez une solution convenue d’avance et un arbre d’appels sur papier.
- Une télémétrie qui survit à l’attaquant : des journaux centralisés et résistants à la falsification, conservés au moins 90 jours, toutes les horloges synchronisées en UTC, y compris les journaux d’identité, des postes et du plan de contrôle cloud.
- Des comptes d’urgence : des identifiants d’administration surveillés, stockés hors ligne, qui ne dépendent pas du fournisseur d’identité dont vous pourriez devoir vous méfier.
- Une matrice de notification : régulateurs, clients et assureurs, chacun avec son délai. Le RGPD, par exemple, impose de notifier à l’autorité de contrôle une violation de données personnelles dans les 72 heures après en avoir pris connaissance.
- Des sauvegardes restaurables : des copies immuables et hors ligne, avec une restauration réellement chronométrée.
La première heure
- Déclarez l’incident et nommez un seul responsable d’incident. Le responsable coordonne et décide ; il ne fait pas l’analyse lui-même.
- Passez la réponse sur le canal hors bande et limitez le cercle au strict nécessaire.
- Lancez immédiatement une chronologie en UTC : chaque observation, action, personne et horodatage. Elle deviendra votre rapport, votre trace juridique et votre retour d’expérience.
- Délimitez avant de toucher à quoi que ce soit : quelles identités, quels hôtes, tenants et données sont concernés, et l’activité est-elle en cours ?
- Préservez les preuves volatiles des systèmes les plus importants avant de modifier leur état.
- Choisissez délibérément une stratégie de confinement (voir plus loin), puis fixez un rythme de points, par exemple toutes les 60 minutes pour un SEV-1.
Tri et gravité
La gravité détermine les effectifs, la communication et le pouvoir de dépense : définissez-la donc en termes métier plutôt que techniques.
- SEV-1 : attaquant actif avec accès à privilèges, exfiltration de données confirmée, exécution d’un rançongiciel ou panne visible par les clients. Mobilisation générale, pont avec la direction, service juridique impliqué.
- SEV-2 : compromission confirmée et limitée (un hôte, un compte), sans preuve de déplacement latéral à ce stade. Intervenants dédiés, point quotidien avec la direction.
- SEV-3 : activité suspecte ou violation de politique sans compromission confirmée. Traitement dans la file de sécurité habituelle.
Preuves : d’abord le plus volatil
Collectez par ordre de volatilité, comme le recommande la RFC 3227 : d’abord la mémoire et l’état du réseau, puis les processus en cours, le disque, et enfin les journaux et les sauvegardes. Calculez l’empreinte de tout ce que vous collectez, notez qui l’a manipulé et quand, et écrivez sur un support séparé, jamais sur le système suspect.
date -u                                        # anchor the timeline in UTC
uptime; who -a; last -Faiwx | head -50         # sessions and logins
ss -tunap                                      # live connections with owning processes
ps auxwwf                                      # full process tree and arguments
ls -l /proc/*/exe 2>/dev/null | grep deleted   # binaries deleted while running
find / -xdev -type f -mtime -2 2>/dev/null     # files changed in the last 48h
sha256sum triage-*.txt > triage.sha256
Capturez d’abord la mémoire avec un outil dédié (par exemple AVML ou LiME sous Linux) sur les systèmes où des implants en mémoire sont plausibles. Sur les charges cloud, faites un instantané des disques et exportez les journaux du plan de contrôle avant de supprimer ou de remplacer quoi que ce soit.
Contenir sans alerter l’attaquant
Une réponse visible et partielle prévient l’attaquant, qui accélère alors, détruit des preuves ou s’enfonce davantage. Délimitez d’abord, puis contenez tout ce que vous connaissez en une seule action coordonnée.
- Isolez les hôtes avec le confinement réseau de l’EDR plutôt que de les éteindre : la mémoire est une preuve.
- Réinitialisez les identifiants en une seule opération coordonnée après la délimitation : utilisateurs touchés, administrateurs, comptes de service, clés d’API et jetons. Des réinitialisations au compte-gouttes permettent à l’attaquant d’observer et de s’adapter.
- Dans Active Directory, réinitialisez deux fois le compte KRBTGT, en laissant la réplication se faire entre les deux, pour invalider les tickets Kerberos falsifiés.
- Dans les tenants cloud, révoquez les sessions et les jetons d’actualisation, changez les clés d’accès et recherchez la persistance de l’attaquant : nouveaux utilisateurs ou rôles IAM, changements de confiance fédérée, consentements d’applications OAuth et règles de transfert de messagerie.
- Bloquez en sortie l’infrastructure de commande et contrôle connue, et attendez-vous à ce que l’attaquant en ait une de secours.
Éradication et reprise
L’éradication est terminée lorsque vous pouvez expliquer l’accès initial et que vous avez supprimé tous les mécanismes de persistance, pas lorsque les alertes s’arrêtent. Recherchez les tâches planifiées et les tâches cron, les nouveaux services, les clés Run, les entrées authorized_keys SSH, les web shells, les comptes d’administration illégitimes et les identifiants CI/CD piégés.
- Reconstruisez les systèmes compromis à partir d’images saines au lieu de les nettoyer sur place.
- Restaurez les données depuis une sauvegarde antérieure à la première activité confirmée de l’attaquant et analysez-la avant de la reconnecter.
- Fermez d’abord le vecteur d’accès initial ; sinon, la reprise n’est qu’une réinfection avec des étapes en plus.
- Remettez les services en ligne par étapes sous surveillance renforcée, avec des détections écrites spécialement pour les techniques de cet attaquant.
Communiquer sous pression
- Gardez une seule source de vérité, tenue par le responsable d’incident, et des points internes factuels : ce que nous savons, ce que nous ne savons pas et ce qui se passe ensuite.
- Impliquez tôt le conseil juridique, pour les obligations de notification et pour protéger l’enquête par le secret professionnel lorsque c’est possible.
- Ne spéculez jamais publiquement sur l’étendue ou l’attribution. Les corrections coûtent plus de crédibilité que le silence.
- En cas de rançongiciel, impliquez les forces de l’ordre et le conseil juridique avant toute discussion de paiement. Le Trésor américain (OFAC) avertit que payer des acteurs sanctionnés peut constituer une infraction.
Après l’action
Organisez une revue sans recherche de coupable dans les deux semaines, tant que les souvenirs sont frais. Reconstruisez toute la chronologie, de l’accès initial à la reprise, et mesurez le temps de présence, le délai de détection et le délai de confinement.
Chaque constat doit aboutir à un changement : une nouvelle détection, un contrôle renforcé, un playbook mis à jour ou un exercice sur table qui teste la lacune. Un incident qui ne change rien se reproduira.
Conclusion
La réponse à incident se passe mieux lorsque les décisions difficiles sont prises à l’avance. Des rôles et une autorité clairs, une première heure répétée, une gestion rigoureuse des preuves et un confinement coordonné évitent qu’un incident grave ne devienne une crise. Analysez ensuite chaque incident et veillez à ce que cette analyse aboutisse à de vrais changements.
- Réponse à incident
- DFIR
- Confinement
- Forensique



