المحتويات
مقدمة
يبدو تشغيل نموذجك الخاص الخيار الآمن. فالأوامر لا تغادر شبكتك أبدًا، ولا يحتفظ أي مزود ببياناتك لمراجعة إساءة الاستخدام، ولا يغيّر أحد النموذج من دون علمك. كل هذا صحيح. لكن الثمن أن كل ضابط كان المزود يتولاه عنك أصبح الآن مسؤوليتك: مصدر الأوزان، ومن يستطيع الوصول إلى خادم الاستدلال، وما يتشاركه مضيف GPU مع جيرانه، وما يرفض النموذج فعله، وكيف تكتشف أن أحدًا يسيء استخدامه.
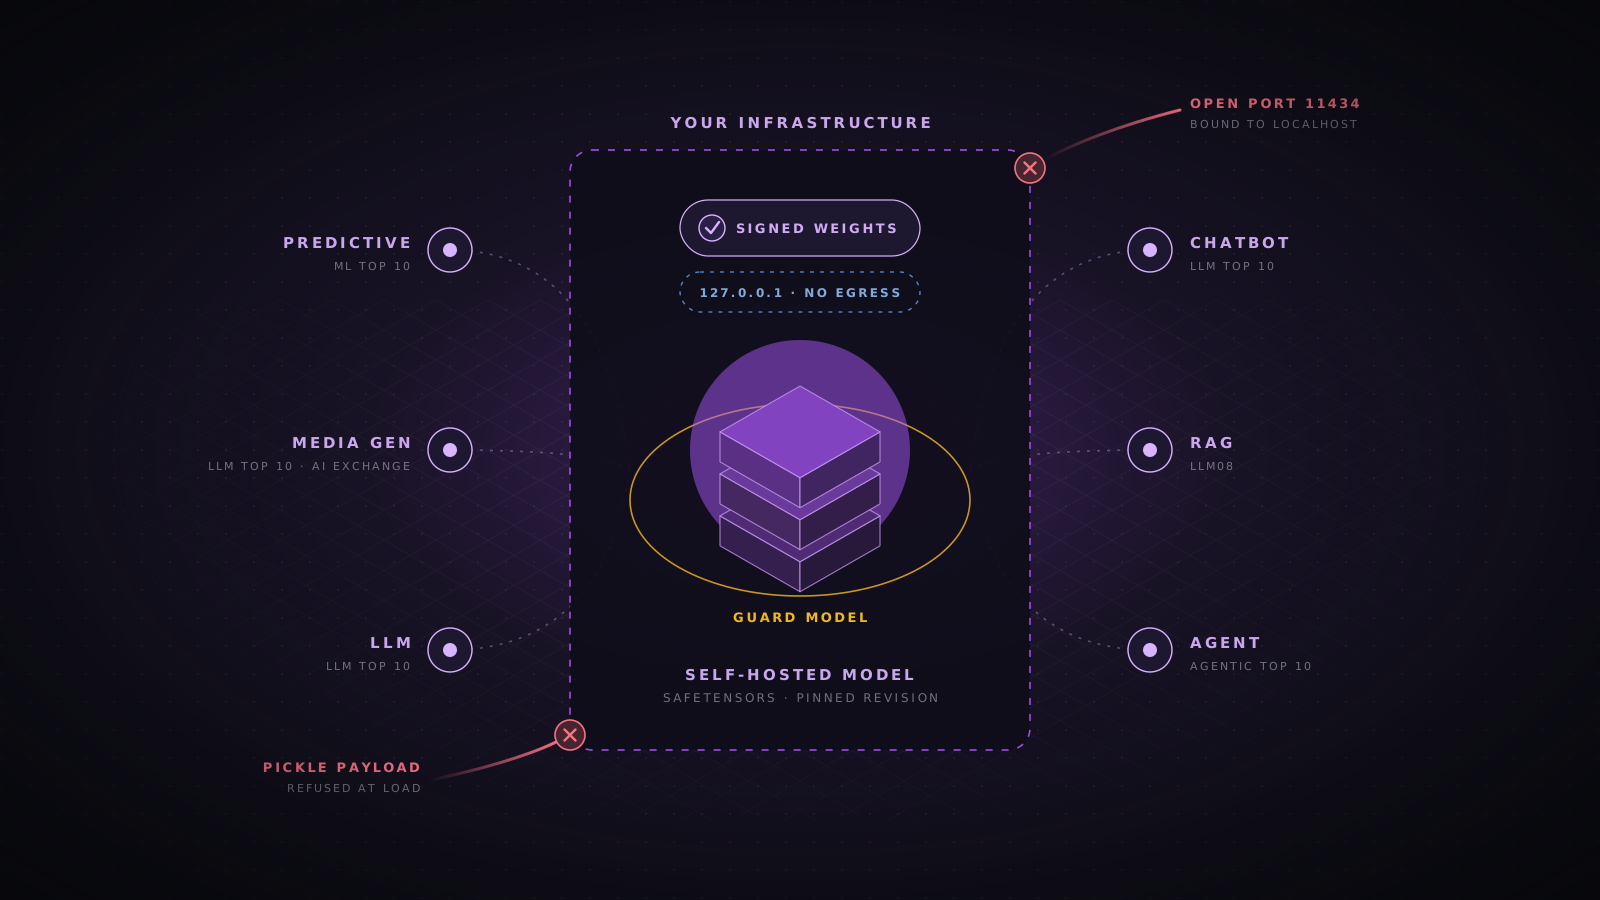
يتناول هذا الدليل النماذج التي تنزّلها أو تدرّبها ثم تشغّلها على عتاد تتحكم فيه، داخل مقرك أو في حسابك السحابي الخاص. يبدأ بما تشترك فيه كل النماذج المستضافة ذاتيًا، مثل الأوزان ومنظومة التشغيل والبنية التحتية، ثم ينتقل إلى المخاطر التي تعتمد على طبيعة النموذج: نموذج تنبؤي، أو مولد صور أو صوت، أو نموذج لغوي كبير، أو روبوت محادثة، أو نظام استرجاع، أو وكيل. ويربط كل قسم بمشاريع OWASP التي تغطيه ويتضمن إعدادات يمكنك تكييفها.
ما الذي يتغير عندما يكون النموذج ملكك
مع واجهة API مستضافة، يشغّل المزود النموذج ويرقّع منظومة التشغيل ويعزل العملاء ويضبط سلوك الرفض ويراقب الإساءة. أما الاستضافة الذاتية فتنقل هذه الطبقات إلى نموذج التهديد الخاص بك. ومعظمها أمن بنية تحتية عادي، لكنه يُطبّق على برمجيات أحدث وأقل تحصينًا، وغالبًا ما تنشرها فرق غير معتادة على تشغيل خدمات مكشوفة للإنترنت.
| الطبقة | مع واجهة API مستضافة | عند الاستضافة الذاتية |
|---|---|---|
| أوزان النموذج | المزود يدرّبها ويخزنها | أنت تتحقق من المصدر وتفحص الملفات وتحميها من السرقة |
| برمجيات التشغيل | المزود يرقّعها ويحصّنها | أنت ترقّع vLLM أو Ollama أو TGI أو Triton وتغلق منافذها المفتوحة افتراضيًا |
| عزل الحوسبة | المزود يعزل العملاء على وحدات GPU لديه | أنت تقرر من يتشارك وحدة GPU وعقدة وعنقودًا |
| سلوك الأمان | المزود يضبط سلوك الرفض ويشغّل مرشحات المحتوى | أنت تختار النموذج وتحافظ على ضبطه الأمني وتضيف نماذج حماية |
| الإساءة والتكلفة | المزود يحدّ المعدل ويرسل لك الفاتورة | أنت تضع سقفًا للرموز والتزامن وإلا خسرت السعة بدل المال |
| بيانات التدريب | المزود يتولى بياناته الخاصة | أنت مسؤول عن التسميم والحفظ والحذف لكل ما تضبط النموذج عليه |
مراجع OWASP التي تعمل انطلاقًا منها
لدى OWASP عدة مشاريع عن أمن الذكاء الاصطناعي. وهي متداخلة، وكل منها أقوى في نوع مختلف من الأنظمة. استخدم المشروع المطابق لما تبنيه قائمة تحقق، واستخدم AI Exchange عندما تحتاج إلى الضوابط التفصيلية وراء أي بند.
| المشروع | يغطي | استخدمه من أجل |
|---|---|---|
| Top 10 for LLM Applications 2025 | عشرة مخاطر للتطبيقات المبنية على النماذج اللغوية، من LLM01 إلى LLM10 | روبوتات المحادثة والمساعدات وRAG وأي منتج يرسل نصًا إلى LLM |
| Machine Learning Security Top 10 | عشرة مخاطر للنماذج المدرّبة، من ML01 إلى ML10، ولا يزال منشورًا كمسودة | المصنِّفات والتقييم والاحتيال والرؤية الحاسوبية وغيرها من النماذج التنبؤية |
| Top 10 for Agentic Applications 2026 | عشرة مخاطر للأنظمة التي تخطط وتتصرف باستخدام الأدوات، من ASI01 إلى ASI10 | الوكلاء وخوادم MCP وسير العمل متعدد الوكلاء وتنفيذ الشيفرة |
| AI Exchange | فهرس كامل لتهديدات الذكاء الاصطناعي وضوابطها، متوافق مع أعمال ISO وقانون الذكاء الاصطناعي الأوروبي | البحث عن الضابط العملي وراء أي بند من قوائم Top 10 |
| LLM AI Cybersecurity and Governance Checklist | أسئلة الحوكمة والجوانب القانونية والجرد والنشر | الموافقة والمراجعة قبل انتقال النموذج إلى الإنتاج |
ابدأ من نوع النموذج الذي تشغّله
يتشارك مصنِّف الاحتيال ووكيل البرمجة وحدة GPU وسلسلة توريد، لكنهما لا يتشاركان شيئًا آخر تقريبًا. حدّد أي الصفوف أدناه تنطبق عليك، لأن النظام الواحد يطابق غالبًا أكثر من صف. فروبوت الدعم الذي يملك استرجاعًا وأداة تذاكر هو روبوت محادثة ونظام RAG ووكيل في آن واحد، ويرث مخاطر الثلاثة.
| النوع | أمثلة | المخاطر الرئيسية | قائمة OWASP الأساسية |
|---|---|---|---|
| نموذج تنبؤي | تقييم الاحتيال وتصنيف الصور وكشف الشذوذ | التهرب والتسميم وعكس النموذج واستنتاج العضوية وسرقة النموذج | ML Security Top 10 |
| مولد وسائط | نماذج الصور بالانتشار وتحويل النص إلى كلام واستنساخ الأصوات والفيديو | محتوى ضار أو غير قانوني وانتحال الشخصية وصور تدريب محفوظة في النموذج | LLM Top 10 وAI Exchange |
| نموذج لغوي | نماذج LLM مفتوحة الأوزان تُشغّل للاستخدام الداخلي أو خلف واجهة API | ضبط أمني ضعيف واستنزاف الموارد وكشف بيانات التدريب | LLM Top 10 |
| روبوت محادثة | دعم العملاء ومكتب المساعدة الداخلي والمساعد العام | كسر القيود وتسريب موجّه النظام والمعلومات المضللة والتسرب بين المستخدمين | LLM Top 10 |
| نظام RAG | البحث والإجابة عن الأسئلة في مستندات الشركة | استرجاع غير مصرح به ومستندات مسمّمة وعكس التضمينات | LLM Top 10 (LLM08) |
| وكيل | وكلاء البرمجة وأتمتة سير العمل والمساعدات التي تستخدم الأدوات | اختطاف الهدف وإساءة استخدام الأدوات وإساءة الصلاحيات وتنفيذ الشيفرة وتسميم الذاكرة | Agentic Top 10 |
تعامل مع الأوزان المنزّلة كشيفرة غير موثوقة
ملف النموذج ليس مجرد أرقام. فصيغة pickle في PyTorch، التي لا تزال شائعة في ملفات .bin و.pt و.pth، يمكنها تنفيذ شيفرة Python عشوائية عند التحميل. وقد وجد باحثون على المنصات العامة نماذج خبيثة كثيرة تفتح reverse shell عند تحميلها، وبعضها صُمم لتجاوز أدوات الفحص التي تشغّلها تلك المنصات. وتصنف OWASP هذا الخطر ضمن LLM03 Supply Chain وML06 AI Supply Chain Attacks.
- حمّل ملفات safetensors فقط. تحتوي هذه الصيغة على موترات وبيانات وصفية ولا يمكنها تنفيذ شيفرة. ارفض ملفات pickle في الإنتاج، وحوّل الموثوق منها في مهمة معزولة.
- لا تفعّل trust_remote_code أبدًا. هذا الخيار يشغّل ملفات Python المرفقة في مستودع النموذج. إذا احتاج نموذج إليه، فاقرأ الشيفرة وانسخها إلى مستودعك الخاص.
- ثبّت المراجعة بدقة. نزّل باستخدام hash الإيداع لا اسم الفرع، حتى لا يستطيع أي دفع لاحق إلى المستودع تغيير ما تنشره.
- أبقِ التحميل بخيار weights_only مفعّلًا. جعل PyTorch 2.6 القيمة weights_only=True افتراضية في torch.load. لا تعطّلها، وحدّث إلى ما بعد الإصدار 2.5.1 الذي احتوى على ثغرة تجاوز مسجلة باسم CVE-2025-32434.
- اعكس النماذج وافحصها. اسحب النماذج إلى سجل داخلي، وافحصها هناك باستخدام ModelScan أو أداة مماثلة، ولا تسمح لعقد الإنتاج بالتنزيل إلا من ذلك السجل.
# Commit hash from the model page, never "main"
REVISION=3f1c2a9e7b5d4c8f0a6e2b1d9c7f5a3e1b0d8c6a

hf download meta-llama/Llama-3.1-8B-Instruct \
  --revision "$REVISION" \
  --include "*.safetensors" "*.json" "tokenizer.model" \
  --local-dir ./models/llama-3.1-8b-instruct

# Fail the pipeline on any unsafe operator or pickle file
modelscan --path ./models/llama-3.1-8b-instructوقّع ما توافق عليه
يخبرك الفحص أن الملف يبدو آمنًا في لحظة معينة. أما التوقيع فيتيح لكل خطوة لاحقة إثبات أنه الملف نفسه. بعد اجتياز النموذج للمراجعة، سجّل hash لكل ملف، ووقّع هذا البيان، واجعل خطوة النشر تتحقق من التوقيع قبل أن يحمّل الخادم أي شيء. ويطبق مشروع OpenSSF model signing هذا النمط على النماذج. ويمنحك Cosign مع بيان للمجاميع الاختبارية الضمان نفسه بأدوات قد تكون تستخدمها بالفعل.
# Approval job
cd models/llama-3.1-8b-instruct
find . -type f ! -name 'MANIFEST*' -print0 | sort -z | xargs -0 sha256sum > MANIFEST.sha256
cosign sign-blob --yes --bundle MANIFEST.bundle MANIFEST.sha256

# Deploy job, before the inference server starts
cosign verify-blob MANIFEST.sha256 --bundle MANIFEST.bundle \
  --certificate-identity "https://github.com/acme/ml-registry/.github/workflows/approve.yml@refs/heads/main" \
  --certificate-oidc-issuer "https://token.actions.githubusercontent.com"
sha256sum --check --strict MANIFEST.sha256أبواب خلفية لن يجدها أي فاحص
صيغة الملف النظيفة لا تعني نموذجًا نظيفًا. فقد تحمل الأوزان بابًا خلفيًا يجعل النموذج يتصرف بشكل طبيعي إلى أن تظهر عبارة أو نمط صورة محفّز، والنسخ المضبوطة المشتقة من النماذج الشائعة مكان سهل لإخفائه. وتغطي OWASP هذا الخطر ضمن LLM04 Data and Model Poisoning وML07 Transfer Learning Attack وML10 Model Poisoning. فضّل النماذج من الناشر الأصلي أو من جهة تثق بها، واقرأ بطاقة النموذج وترخيصه، واحتفظ بجرد يتضمن مصدر كل نموذج تشغّله وhash الخاص به، وقيّم أي نموذج جديد على مجموعة الاختبار الخاصة بك قبل أن يحل محل القديم.
أحكِم إغلاق خادم الاستدلال
بُنيت معظم خوادم النماذج لباحثين يعملون على شبكة موثوقة. فليس لدى Ollama أي مصادقة على الإطلاق، وتكشف عمليات المسح على الإنترنت باستمرار آلاف النسخ المربوطة بالعنوان 0.0.0.0 حيث يستطيع أي شخص تشغيل النماذج أو سحبها أو حذفها. وقد سمحت ثغرة اجتياز مسار في Ollama، هي CVE-2024-37032، بتنفيذ شيفرة عن بُعد على المضيفين المكشوفين. أما واجهة Ray Jobs API، المستخدمة في كثير من عناقيد التدريب والتشغيل، فتقبل المهام دون مصادقة بحكم تصميمها، واستخدمتها حملة ShadowRay عام 2024 للسيطرة على عناقيد GPU. كما صدرت لكل من NVIDIA Triton وvLLM تنبيهات حرجة في مكونات تستقبل مدخلات من الشبكة.
- اربطه بـ localhost أو بواجهة خاصة. يجب ألا يكون خادم النموذج قابلًا للوصول من الإنترنت أبدًا، وفي معظم الحالات ولا من بقية شبكة الشركة أيضًا.
- ضع أمامه وكيلًا يتحقق من الهوية. تتحقق البوابة أو الوكيل العكسي من الهوية وحجم الطلب ومعدله قبل أن يصل أي شيء إلى النموذج.
- اكشف مسارات الاستدلال فقط. احجب نقاط إدارة النماذج مثل pull وdelete وload وmetrics عن كل من ليس من المشغّلين.
- رقّع وفق جدول زمني. تابع التنبيهات الأمنية للخادم واعتمادياته في Python ومنظومة CUDA، وأعد بناء الصور عند تغيرها.
- شغّله دون صلاحيات. استخدم مستخدمًا غير root ونظام ملفات جذريًا للقراءة فقط وتركيبًا للقراءة فقط للأوزان.
vllm serve ./models/llama-3.1-8b-instruct \
  --served-model-name assistant \
  --host 127.0.0.1 --port 8000 \
  --api-key "$VLLM_API_KEY" \
  --max-model-len 8192 \
  --max-num-seqs 32 \
--generation-config vllmlimit_req_zone $binary_remote_addr zone=llm:10m rate=10r/s;
server {
listen 443 ssl;
server_name llm.internal.example.com;
client_max_body_size 256k;
location = /v1/chat/completions {
auth_request /_auth;
limit_req zone=llm burst=20 nodelay;
proxy_read_timeout 120s;
proxy_pass http://127.0.0.1:8000;
}
location = /_auth {
internal;
proxy_pass http://127.0.0.1:9000/verify;
proxy_pass_request_body off;
proxy_set_header Content-Length "";
}
location / { return 404; }
}مضيفو GPU والعزل وسرقة الأوزان
الأوزان التي ضبطتها على بيانات الشركة أصل ومخزن بيانات في الوقت نفسه. وتصنف OWASP سرقة النموذج ضمن ML05 Model Theft، كما أن المهاجم الذي يملك نسخة منه يستطيع دراستها دون اتصال لبناء هجمات على نظامك الحي. احمِ الأوزان كما تحمي قاعدة بيانات إنتاجية، وصمّم المضيفين بحيث لا تستطيع عملية استدلال مخترقة الوصول إلى أي شيء آخر.
- اعزل عبء العمل. شغّل الاستدلال على مجموعة عقد أو مضيفين مخصصين، دون عملاء آخرين، ودون وصول إلى بيانات التدريب أو إلى مسار الكتابة في سجل النماذج.
- اختر مشاركة GPU عن قصد. تقسّم تقنية NVIDIA MIG الذاكرة وذاكرة التخزين المؤقت على مستوى العتاد. أما time slicing وMPS فلا يوفران العزل نفسه، فلا تستخدمهما أبدًا بين عملاء يجب ألا يرى بعضهم بعضًا.
- تذكّر تسرب ذاكرة GPU. أظهرت ثغرة LeftoverLocals، وهي CVE-2023-4969، أن بعض وحدات GPU من Apple وAMD وQualcomm وImagination تسمح لعملية بقراءة الذاكرة التي تركتها عملية أخرى، بما في ذلك مخرجات النموذج.
- شفّر الأوزان وقيّد الوصول إليها. شفّر وحدة التخزين أو الحاوية، ولا تمنح صلاحية القراءة إلا لهوية التشغيل، واضبط تنبيهات على القراءات الكبيرة أو النسخ من أي جهة أخرى.
- امنع الاتصالات الصادرة. حاوية الاستدلال تحتاج إلى الرد على الطلبات لا إلى فتح اتصالات. احجب الحركة الصادرة حتى لا يستطيع خادم مخترق إرسال الأوزان أو الأوامر إلى الخارج.
- فكّر في الحوسبة السرية. للنماذج عالية القيمة على عتاد سحابي مشترك، تدعم وحدات GPU مثل H100 وضع حوسبة سرية يشفّر البيانات أثناء استخدامها.
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
  name: llm-inference-isolation
  namespace: llm-serving
spec:
  podSelector:
    matchLabels:
      app: vllm
  policyTypes: [Ingress, Egress]
  ingress:
    - from:
        - namespaceSelector:
            matchLabels:
              kubernetes.io/metadata.name: ai-gateway
      ports:
        - protocol: TCP
          port: 8000
egress: []النماذج التنبؤية وتعلم الآلة التقليدي
لا تجري المصنِّفات ونماذج التقييم محادثات، لكنها تتخذ قرارات تهم المهاجمين: قبول دفعة أو حظرها، والإبلاغ عن تسجيل دخول أو تمريره، وقبول مستند أو رفضه. وقائمة OWASP Machine Learning Security Top 10 هي المرجع هنا. وتنقسم هجماتها إلى ثلاث مجموعات: خداع النموذج وقت الاستدلال، وإفساده أثناء التدريب، واستخلاص معلومات خاصة من إجاباته.
| الخطر | كيف يبدو | الضوابط الرئيسية |
|---|---|---|
| ML01 Input Manipulation | تغييرات صغيرة في المدخل تقلب النتيجة، مثل معاملة معدّلة تتجاوز فحوص الاحتيال | التدريب العدائي والتحقق من المدخلات ومجموعات النماذج وقواعد لا تعتمد على النموذج وحده |
| ML02 Data Poisoning | سجلات مصطنعة في بيانات التدريب تزيح النموذج أو تزرع فيه محفّزًا | مصدر البيانات وضبط الوصول إلى مجموعات البيانات وفحص القيم الشاذة قبل كل تدريب |
| ML03 Model Inversion | استعلامات متكررة تعيد بناء خصائص سجلات التدريب، مثل الوجوه | إرجاع التصنيفات بدل الدرجات الخام وحدود المعدل والخصوصية التفاضلية |
| ML04 Membership Inference | يعرف المهاجم ما إذا كان شخص ما ضمن مجموعة التدريب | التنظيم والخصوصية التفاضلية وقيم ثقة تقريبية |
| ML05 Model Theft | تُنسخ الأوزان، أو يُستنسخ النموذج من إجاباته نفسها | حماية الأوزان وميزانيات الاستعلام ومراقبة الاستكشاف المنهجي |
| ML06 AI Supply Chain Attacks | مكتبات أو نماذج مدرّبة مسبقًا أو مجموعات بيانات مخترقة | اعتماديات مثبّتة ومفحوصة ونماذج موقّعة ومرايا داخلية |
| ML07 Transfer Learning Attack | باب خلفي في نموذج أساسي يبقى بعد الضبط | نماذج أساسية موثوقة وتقييم على مجموعات الاختبار والمحفزات الخاصة بك |
| ML08 Model Skewing | يغذي المهاجمون حلقة التغذية الراجعة حتى ينحرف إعادة التدريب لصالحهم | التحقق من بيانات التغذية الراجعة وتحديد وزن كل مصدر ومراجعة الانحراف |
| ML09 Output Integrity Attack | تُغيَّر النتائج بين النموذج والنظام الذي يستخدمها | نقل مصادق عليه وموقّع بين الخدمات وفحوص سلامة |
| ML10 Model Poisoning | تُعدَّل الأوزان مباشرة لتغيير السلوك | الكتابة مقصورة على مسار التدريب وعناصر موقّعة وفحص hash عند التحميل |
يحتاج كثير من هذه الهجمات إلى درجات عالية الدقة واستعلامات كثيرة. وأرخص دفاع هو ألا تعيد إلا ما يحتاج إليه المستدعي: قرارًا، أو درجة ثقة مقرّبة إلى قيمة تقريبية، وليس متجه الاحتمالات الكامل أبدًا. واجمع ذلك مع ميزانيات استعلام لكل عميل وتنبيه للعملاء الذين يرسلون مدخلات كثيرة شبه متطابقة، فهذا هو شكل حركة الاستخراج والعكس.
from pydantic import BaseModel

DECISION_THRESHOLD = 0.8
SCORE_STEP = 0.1

class FraudVerdict(BaseModel):
    decision: str
    score: float

def verdict(probabilities: list[float]) -> FraudVerdict:
    fraud = probabilities[1]
    coarse = round(round(fraud / SCORE_STEP) * SCORE_STEP, 1)
    return FraudVerdict(decision="review" if fraud >= DECISION_THRESHOLD else "allow", score=coarse)
عندما يُدرَّب النموذج على بيانات شخصية، تضع الخصوصية التفاضلية حدًا قابلًا للقياس لما يمكن أن يساهم به أي سجل، مما يضعف مباشرة استنتاج العضوية والعكس. وهي تكلّف بعض الدقة، فاختبرها على بياناتك. وتضيفها مكتبات مثل Opacus الخاصة بـ PyTorch إلى حلقة تدريب قائمة.
from opacus import PrivacyEngine

privacy_engine = PrivacyEngine()
model, optimizer, train_loader = privacy_engine.make_private_with_epsilon(
    module=model,
    optimizer=optimizer,
    data_loader=train_loader,
    epochs=EPOCHS,
    target_epsilon=8.0,
    target_delta=1e-5,
    max_grad_norm=1.0,
)مولدات الصور والصوت والفيديو
في الوسائط التوليدية، الخطر الرئيسي هو ما ينتجه النموذج لا ما يسرّبه. فنموذج صور أو أصوات مستضاف ذاتيًا ونُزعت منه أجزاء الأمان يمكنه إنتاج صور حميمة دون موافقة، ومواد اعتداء جنسي على الأطفال، ونسخ أصوات جاهزة للاحتيال، وأدلة مزيفة. إذا كان الخادم خادمك، فالمخرجات مخرجاتك، قانونيًا وإعلاميًا. يشغّل المزودون المستضافون مرشحات للأوامر ومصنِّفات للمخرجات وفرقًا لمكافحة الإساءة. وتحتاج أنت إلى نسختك الخاصة من كل منها.
- أبقِ safety checker. تأتي مسارات الانتشار مع safety checker تنصح أدلة كثيرة بتعطيله. اتركه مفعّلًا، وأضف مصنِّف مخرجات مخصصًا للفئات التي تهمك.
- رشّح الأوامر والمخرجات. افحص الأمر قبل التوليد والصورة أو الصوت بعده. فترشيح الأمر وحده سهل التجاوز بالأخطاء الإملائية واللغات الأخرى.
- احظر الأشخاص الحقيقيين افتراضيًا. ارفض الطلبات التي تذكر أفرادًا حقيقيين أو ترفع عينة وجه أو صوت، ما لم تكن الميزة مدعومة بعملية موافقة.
- تحكّم في الإضافات. محوّلات LoRA والتضمينات ونقاط الحفظ المخصصة تغيّر سلوك النموذج وقد تكون شيفرة pickle. طبّق عليها قواعد سلسلة التوريد نفسها المطبقة على الأوزان الأساسية.
- علّم ما تولّده. أرفق بيانات اعتماد المحتوى C2PA، وأضف علامة مائية غير مرئية حيث يدعمها نموذجك، حتى يمكن التعرف على مخرجاتك لاحقًا.
- راقب الحفظ. يمكن لنماذج الانتشار إعادة إنتاج صور التدريب بشكل شبه مطابق. إذا ضبطت النموذج على صور خاصة أو مرخّصة، فاختبر وجود نسخ شبه مكررة قبل الإطلاق.
النماذج اللغوية التي تشغّلها بنفسك
نموذج LLM مفتوح الأوزان لا يكون آمنًا إلا بقدر ضبطه، وهذا الضبط يسهل فقدانه. فقد أظهرت أبحاث نشرها Qi وزملاؤه عام 2023 أن ضبط نموذج متوائم على مجموعة صغيرة من الأمثلة، حتى غير الضارة منها، يمكن أن يزيل جزءًا كبيرًا من سلوك الرفض لديه. أما النسخ abliterated وuncensored على المنصات العامة فقد أُزيل منها الرفض عمدًا. إذا ضبطت النموذج، فعليك قياس الأمان من جديد بعد ذلك، لأنه سيكون قد تغيّر.
- اختر نموذج instruct من الناشر الأصلي. فهو الذي حظي بأكبر قدر من العمل الأمني. وتجنب الدمج المجتمعي والنسخ uncensored في أي شيء يصل إليه المستخدمون.
- أضف نموذج حماية. مرّر المدخل والمخرج على مصنِّف مثل Llama Guard أو ShieldGemma أو Granite Guardian. إنه نموذج منفصل، لذا فإن كسر قيود النموذج الرئيسي لا يعطّله.
- أعد التقييمات بعد كل ضبط. استخدم اختبارات الرفض وكسر القيود نفسها التي أجريتها على النموذج الأساسي، ولا تطلق النموذج إذا ساءت النتائج.
- احمِ مجموعة التدريب. النموذج المضبوط على التذاكر أو الرسائل أو الشيفرة قد يكررها حرفيًا. وهذا هو خطر LLM02 Sensitive Information Disclosure. أزل الأسرار والبيانات الشخصية قبل التدريب، واختبر الاسترجاع الحرفي.
- قيّد كل طلب. يعني خطر LLM10 Unbounded Consumption على عتادك الخاص أن بضعة أوامر طويلة قد تستهلك كل ذاكرة GPU. ضع سقفًا لطول السياق ورموز المخرجات والتسلسلات المتزامنة ومدة الطلب.
from openai import OpenAI

guard = OpenAI(base_url="http://127.0.0.1:8001/v1", api_key=GUARD_API_KEY)

def is_safe(conversation: list[dict[str, str]]) -> bool:
    result = guard.chat.completions.create(
        model="llama-guard",
        messages=conversation,
        max_tokens=20,
        temperature=0,
    )
    verdict = (result.choices[0].message.content or "").strip().lower()
    return verdict.startswith("safe")

# Check the user turn before generation, then the full exchange after it
if not is_safe([{"role": "user", "content": user_text}]):
raise RefusedRequest("input")روبوتات المحادثة والمساعدات
يضع روبوت المحادثة نموذجًا لغويًا أمام أشخاص سيحاولون دفعه إلى سلوك خاطئ. وهذه المخاطر هي جوهر قائمة OWASP LLM Top 10، ولا تصغر لأن النموذج يعمل على عتادك. لكن الاستضافة الذاتية تمنحك هنا تحكمًا أكبر، إذ يمكنك تغيير النموذج والحماية والتسجيل دون انتظار مزود.
- LLM01 Prompt Injection. سيحاول المستخدمون تجاوز تعليماتك. أبقِ التعليمات في دور النظام، وافحص المدخلات بنموذج حماية، ولا تدع المحادثة تقرر أبدًا البيانات أو الإجراءات المسموح بها للمستخدم.
- LLM07 System Prompt Leakage. افترض أن موجّه النظام سيُعرض على مستخدم ما. يمكنه وصف الأسلوب والنطاق، لكن يجب ألا يحتوي على بيانات اعتماد أو أسماء مضيفين داخليين أو قواعد وصول.
- LLM05 Improper Output Handling. اعرض الردود كنص أو كـ Markdown منقّى، واحجب الصور البعيدة والروابط غير المعروفة، التي يمكن استخدامها لإخراج البيانات من الصفحة.
- LLM09 Misinformation. سيقول الروبوت أشياء خاطئة بثقة. ففي عام 2024 حمّلت محكمة كندية شركة Air Canada المسؤولية عن شروط استرداد اخترعها روبوت المحادثة الخاص بها، في قضية Moffatt v. Air Canada. اربط الإجابات بمحتواك الخاص، واعرض المصادر، ووجّه أسئلة السياسات والأسعار والقانون إلى إجابات ثابتة أو إلى إنسان.
- عزل المحادثات. خزّن السجل لكل مستخدم ولكل جلسة، مفهرسًا بالهوية المصادق عليها، ولا تعد استخدام محادثة كسياق لمستخدم آخر أبدًا. ويجب كذلك ألا تتسرب ذاكرة التخزين المؤقت المشتركة للأوامر بين العملاء.
- الإساءة والاحتفاظ. حدّ المعدل لكل مستخدم، وسجّل محاولات كسر القيود، ولا تحتفظ بالنصوص إلا للمدة التي تحتاج إليها، في مخزن له ضوابط وصول خاصة.
التوليد المعزز بالاسترجاع
يمنح الاسترجاع النموذج مستنداتك، مما يجعله مفيدًا ويجعله أيضًا طريقًا إلى بيانات لا ينبغي للمستخدم رؤيتها. وتغطي OWASP هذا الخطر ضمن LLM08 Vector and Embedding Weaknesses. والقاعدة هي نفسها في أي وصول إلى البيانات: استعلام الاسترجاع يفرض صلاحيات المستخدم، بقيم تأتي من الجلسة وليس من النموذج أبدًا.
from qdrant_client import QdrantClient, models

client = QdrantClient(url="http://qdrant.internal:6333", api_key=QDRANT_API_KEY)

def search(session: Session, query_vector: list[float]) -> list[models.ScoredPoint]:
    access = models.Filter(must=[
        models.FieldCondition(key="tenant_id", match=models.MatchValue(value=session.tenant_id)),
        models.FieldCondition(key="groups", match=models.MatchAny(any=session.group_ids)),
    ])
    return client.query_points(
        collection_name="documents",
        query=query_vector,
        query_filter=access,
        limit=8,
).points- تعامل مع المستندات كمدخلات غير موثوقة. كل من يستطيع الكتابة في مصدر مفهرس، مثل صفحة wiki أو تذكرة أو مجلد مشترك، يمكنه زرع تعليمات سيقرؤها النموذج. علّم النص المسترجع كبيانات داخل الأمر، ولا تمنح روبوت RAG أدوات تكتب أو ترسل.
- تحكّم فيما تتم فهرسته. لا تفهرس إلا المصادر المعتمدة، وسجّل أصل كل جزء، وأزل النص المخفي والتعليقات والبيانات الوصفية أثناء الاستيعاب.
- احمِ قاعدة المتجهات. يمكن عكس التضمينات جزئيًا لاستعادة النص. امنح القاعدة مصادقة وتشفيرًا والتصنيف نفسه الممنوح للمستندات المصدر.
- حافظ على تزامن الصلاحيات. عندما يُحذف مستند أو تتغير مشاركته، حدّث أجزاءه أو احذفها، وإلا أصبح الاسترجاع وسيلة لقراءة محتوى أُلغي الوصول إليه.
الوكلاء واستخدام الأدوات
يحوّل الوكيل مخرجات النموذج إلى أفعال: يقرأ الملفات ويستدعي واجهات API وينفذ الشيفرة ويتواصل مع وكلاء آخرين. وعندها لا يعود الحقن الناجح مجرد إجابة سيئة، بل يصبح تغييرًا حقيقيًا في نظام حقيقي. وقد كُتبت قائمة OWASP Top 10 for Agentic Applications 2026، التي نشرها OWASP GenAI Security Project في ديسمبر 2025، لهذه الحالة. وغالبًا ما يُمنح الوكلاء المستضافون ذاتيًا صلاحيات أكثر من المستضافين لدى مزود، لأنهم يعملون داخل الشبكة، لذا تزداد أهمية هذه الضوابط.
| الخطر | الضوابط الرئيسية |
|---|---|
| ASI01 Agent Goal Hijack | التعامل مع كل محتوى مسترجع أو صادر عن الأدوات كبيانات، وإبقاء الأهداف في إعدادات ثابتة، وتأكيد الإجراءات عالية الأثر من إنسان |
| ASI02 Tool Misuse and Exploitation | أقل مجموعة أدوات لكل مهمة، ومخططات صارمة للوسائط، ووجهات ضمن قائمة سماح، وحدود معدل لكل أداة |
| ASI03 Identity and Privilege Abuse | تعمل الأدوات بصلاحيات المستخدم النهائي، وبيانات اعتماد قصيرة العمر ومحدودة النطاق، ودون حسابات خدمة مشتركة |
| ASI04 Agentic Supply Chain Vulnerabilities | مراجعة خوادم MCP والإضافات وقوالب الأوامر وتثبيت إصداراتها، وتشغيلها في بيئة معزولة خاصة بها |
| ASI05 Unexpected Code Execution | تشغيل الشيفرة المولّدة في بيئة معزولة دون شبكة ودون أسرار، وعدم استخدام eval على المضيف أبدًا |
| ASI06 Memory and Context Poisoning | ذاكرة منفصلة لكل مستخدم، والتحقق مما يُكتب في الذاكرة طويلة الأمد، وإتاحة المراجعة والحذف |
| ASI07 Insecure Inter-Agent Communication | مصادقة كل استدعاء بين الوكلاء وتفويضه، وتوقيع الرسائل، وعدم الثقة أبدًا بما يدّعيه وكيل آخر عن المستخدم |
| ASI08 Cascading Failures | حدود للخطوات والرموز والإنفاق، وقواطع دائرة بين الوكلاء، ومفتاح إيقاف لكل سير عمل |
| ASI09 Human-Agent Trust Exploitation | عرض الإجراء الدقيق وأثره قبل الموافقة، وعدم السماح للوكيل بكتابة نص التأكيد |
| ASI10 Rogue Agents | جرد كل وكيل وصلاحياته، وتسجيل جميع الإجراءات، وكشف السلوك الخارج عن النطاق المعلن |
يستحق تنفيذ الشيفرة حدًا خاصًا به. إذا كان الوكيل قادرًا على تشغيل الشيفرة، فافترض أنه سيشغّل يومًا ما شيفرة كتبها مهاجم. يجب ألا تملك البيئة المعزولة شبكة ولا بيانات اعتماد، وأن ترى مدخلاتها للقراءة فقط، وأن تخضع لحدود على الوقت والذاكرة والعمليات. وتوفر نواة في مساحة المستخدم مثل gVisor، أو آلة افتراضية مصغرة مثل Firecracker، جدارًا أقوى بكثير من حاوية عادية.
docker run --rm \
  --runtime=runsc \
  --network none \
  --read-only --tmpfs /tmp:rw,size=64m \
  --cap-drop ALL --security-opt no-new-privileges \
  --pids-limit 128 --memory 512m --cpus 1 \
  --user 65534:65534 \
  -v "$JOB_DIR:/work:ro" \
  python:3.12-slim timeout 30 python /work/main.py
خوادم MCP وإضافات الأدوات شيفرة تعمل بأي صلاحيات تمنحها لها. ثبّتها من مصادر راجعتها، وثبّت إصداراتها، وامنح كلًا منها بيانات اعتماد خاصة محصورة في مهمة واحدة، وشغّل الخوادم المحلية في النوع نفسه من البيئات المعزولة. كما أن وصف الأداة نص يقرؤه النموذج، لذا يستطيع خادم خبيث حقن تعليمات عبر بياناته الوصفية نفسها.
اختبر النموذج كما يفعل المهاجم
لا يمكنك الاعتماد على الفريق الأحمر لدى مزود، لذا أنشئ فريقك الخاص. احتفظ بمجموعة اختبارات أمنية إلى جانب تقييمات الجودة، وشغّلها عند كل تغيير في الأوزان أو موجّه النظام أو نموذج الحماية أو الأدوات أو إعدادات التشغيل. اختبر النظام كاملًا كما يصل إليه المستخدمون، لا النموذج المجرد فقط، لأن معظم الإخفاقات تأتي من طريقة ترابط الأجزاء.
- تفحص أداة garak النموذج اللغوي بحثًا عن كسر القيود وحقن الأوامر وتسرب البيانات والمخرجات المسيئة.
- تؤتمت أداة PyRIT من Microsoft هجمات متعددة الجولات على تطبيق كامل.
- تولّد أداة promptfoo حالات فريق أحمر من إعداداتك الخاصة وتشغّلها في CI.
- تختبر Adversarial Robustness Toolbox النماذج التنبؤية ضد التهرب والتسميم والعكس والاستخراج.
export OPENAI_API_KEY="$VLLM_API_KEY"
python -m garak \
  --model_type openai.OpenAICompatible \
  --model_name assistant \
  --generator_option_file garak-local.json \
  --probes promptinject,dan,leakreplay,encoding \
--report_prefix nightlyالمراقبة والاستجابة للحوادث
سجّل كل طلب في البوابة مع المستخدم واسم النموذج ومراجعته وعدد الرموز وأحكام الحماية واستدعاءات الأدوات وزمن الاستجابة. ولا تحتفظ بالأوامر والمخرجات الكاملة إلا في مخزن مقيّد بمدة احتفاظ قصيرة. وأرسل هذه السجلات، مع سجلات تدقيق المضيفين وKubernetes والسجل، إلى نظام SIEM لديك.
- الإساءة. قفزات في الرموز لكل مستخدم، وحجب متكرر من الحماية لحساب واحد، وسلاسل طويلة من الاستعلامات شبه المتطابقة.
- البنية التحتية. عمليات جديدة أو اتصالات صادرة على مضيفي الاستدلال، ووصول إلى مسارات إدارة النماذج، وتغييرات في صورة التشغيل.
- الأوزان. قراءات لحاوية النماذج من أي هوية غير دور التشغيل، وقيمة hash للنموذج عند التحميل لا تطابق البيان الموقّع.
- الوكلاء. استدعاءات أدوات رفضتها فحوص التفويض، وانتهاكات للبيئة المعزولة، وإجراءات خارج النطاق المعلن.
اكتب أدلة التشغيل قبل أن تحتاج إليها. في حالة كسر القيود أو المخرجات الضارة، تكون الخطوة الأولى قاعدة حماية أو مفتاح ميزة، لا إعادة تدريب. وفي حالة نموذج مسمّم أو مزوّد بباب خلفي، ارجع إلى آخر نسخة موقّعة واكتشف كيف دخلت النسخة السيئة. وفي حالة سرقة الأوزان، افترض أن المهاجم يستطيع الآن اختبار الهجمات دون اتصال، وغيّر كل الأسرار التي كان بإمكان النموذج أو مساره الوصول إليها، وراجع بيانات التدريب التي قد يكشفها النموذج.
قائمة تحقق قبل الإنتاج
- الجرد. كل نموذج مسجل بمصدره ومراجعته وقيمة hash وترخيصه ومالكه والبيانات التي ضُبط عليها.
- سلسلة التوريد. الأوزان بصيغة safetensors من مراجعة مثبّتة، ومفحوصة وموقّعة ويُتحقق منها عند النشر.
- الخادم. خادم الاستدلال مربوط بواجهة خاصة، ويقع خلف وكيل يتحقق من الهوية، ويعمل دون root.
- العزل. يعمل الاستدلال على عقد مخصصة، ومشاركة GPU خيار مقصود، والاتصالات الصادرة ممنوعة.
- الحدود. طول السياق ورموز المخرجات والتزامن ومدة الطلب والميزانيات لكل مستخدم كلها محددة.
- الأمان. نموذج حماية يفحص المدخل والمخرج، وأُعيدت تقييمات الأمان بعد أي ضبط.
- البيانات. يرشّح الاسترجاع حسب صلاحيات المستخدم، ونُظّفت بيانات التدريب من الأسرار والبيانات الشخصية.
- الوكلاء. تعمل الأدوات بصلاحيات المستخدم، وتُشغّل الشيفرة في بيئة معزولة دون شبكة، وتتطلب الآثار الجانبية تأكيدًا.
- الاختبار. تعمل مجموعة الفريق الأحمر في CI عند كل تغيير في النموذج أو الأمر أو الأداة أو الإعدادات.
- الاستجابة. تصل السجلات إلى SIEM، واختُبرت أدلة التراجع ومفتاح الإيقاف وسرقة الأوزان مرة واحدة على الأقل.
الخاتمة
تُبقي الاستضافة الذاتية بياناتك داخل شبكتك، لكنها لا تجعل النموذج جديرًا بالثقة. فأنت تتحمل سلسلة توريد من ملفات ثنائية كبيرة، ومنظومة تشغيل حديثة بإعدادات افتراضية ضعيفة، وبنية تحتية من وحدات GPU، والعمل الأمني الذي كان المزود سيتولاه. وتمنحك قوائم OWASP خريطة لكل نوع من الأنظمة: قائمة ML Top 10 للنماذج التنبؤية، وقائمة LLM Top 10 للنماذج اللغوية وروبوتات المحادثة وRAG، وقائمة Agentic Top 10 حين يصبح النموذج قادرًا على الفعل. تحقق مما تحمّله، وأبقِ الخادم خاصًا، وقيّد ما يستطيع النموذج الوصول إليه، واختبره كما يفعل المهاجم.
المصادر
- OWASP Gen AI Security Project، قائمة Top 10 for LLM Applications 2025.
- OWASP Gen AI Security Project، قائمة Top 10 for Agentic Applications 2026 (ديسمبر 2025).
- OWASP Machine Learning Security Top 10 (مسودة).
- OWASP AI Exchange، owaspai.org.
- OWASP LLM AI Cybersecurity and Governance Checklist.
- Qi وآخرون، «Fine-tuning Aligned Language Models Compromises Safety, Even When Users Do Not Intend To!» (2023).
- Oligo Security، بحث ShadowRay حول CVE-2023-48022 (مارس 2024).
- Wiz Research، بحث Probllama حول CVE-2024-37032 في Ollama (يونيو 2024).
- Trail of Bits، بحث LeftoverLocals حول CVE-2023-4969 (يناير 2024).
- Moffatt v. Air Canada، 2024 BCCRT 149.
- توثيق safetensors، Hugging Face.
- ModelScan، Protect AI.
- توثيق التوقيع في Sigstore cosign.
- OpenSSF model signing (model-transparency).
- توثيق vLLM.
- Llama Guard 3، Meta PurpleLlama.
- توثيق Qdrant.
- توثيق gVisor.
- Opacus، الخصوصية التفاضلية لـ PyTorch.
- NVIDIA garak، أداة فحص ثغرات النماذج اللغوية.
- Microsoft PyRIT، أداة Python Risk Identification Tool.
- المواصفة التقنية C2PA 2.1.
- أمن الذكاء الاصطناعي
- ذكاء اصطناعي مستضاف ذاتيًا
- OWASP LLM Top 10
- OWASP ML Top 10
- الذكاء الاصطناعي الوكيلي
- سلسلة توريد النماذج
- vLLM
- Ollama
- RAG
- روبوتات المحادثة