Sommaire
Introduction
Exécuter votre propre modèle semble être le choix sûr. Les prompts ne quittent jamais votre réseau, aucun fournisseur ne conserve vos données pour un contrôle d’abus, et personne ne change le modèle à votre insu. Tout cela est vrai. Le prix à payer est que chaque contrôle qu’un fournisseur assurait pour vous vous revient désormais : l’origine des poids, qui peut joindre le serveur d’inférence, ce que l’hôte GPU partage avec ses voisins, ce que le modèle refuse de faire, et la manière dont vous remarquez qu’on en abuse.
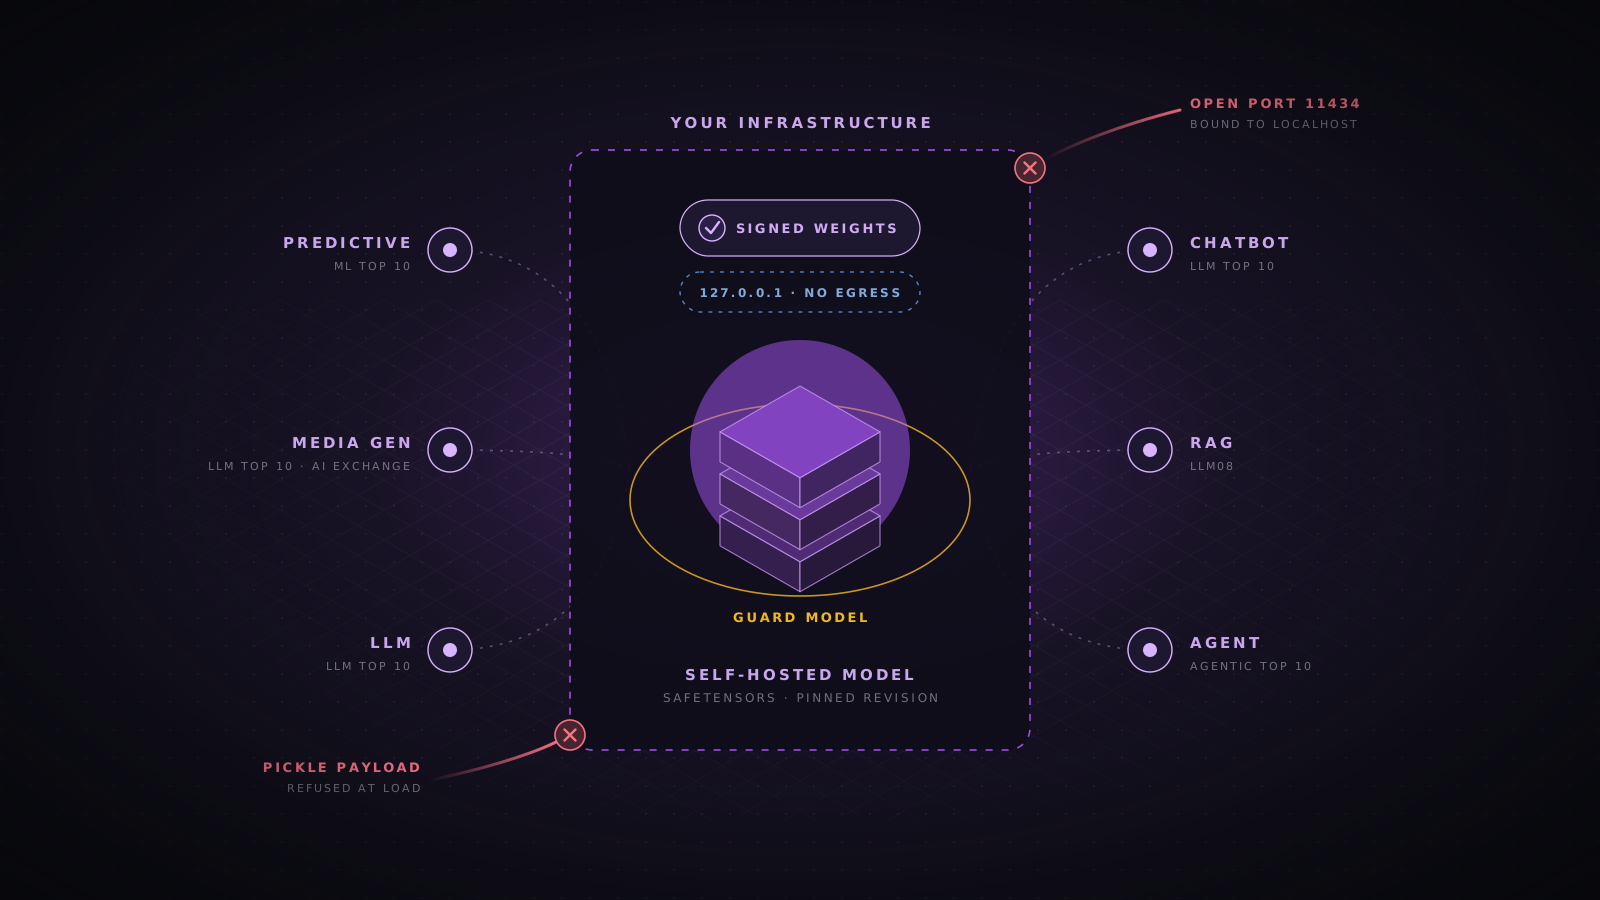
Ce guide traite des modèles que vous téléchargez ou entraînez puis servez sur du matériel que vous contrôlez, sur site ou dans votre propre compte cloud. Il part de ce que tout modèle autohébergé a en commun, comme les poids, la pile de service et l’infrastructure, puis passe aux risques qui dépendent de la nature du modèle : un modèle prédictif, un générateur d’images ou d’audio, un grand modèle de langage, un chatbot, un système de recherche documentaire ou un agent. Chaque section renvoie aux projets OWASP qui la couvrent et contient une configuration à adapter.
Ce qui change quand le modèle est à vous
Avec une API hébergée, le fournisseur exécute le modèle, corrige la pile de service, isole les clients, règle les refus et surveille les abus. L’autohébergement fait entrer ces couches dans votre modèle de menace. La plupart relèvent de la sécurité d’infrastructure classique, appliquée à des logiciels plus jeunes, moins durcis et souvent déployés par des équipes peu habituées à exploiter des services exposés à Internet.
| Couche | Avec une API hébergée | En autohébergement |
|---|---|---|
| Poids du modèle | Le fournisseur les entraîne et les stocke | Vous vérifiez la source, analysez les fichiers et les protégez contre le vol |
| Logiciel de service | Le fournisseur le corrige et le durcit | Vous corrigez vLLM, Ollama, TGI ou Triton et fermez leurs ports ouverts par défaut |
| Isolation du calcul | Le fournisseur isole les clients sur ses GPU | Vous décidez qui partage un GPU, un nœud et un cluster |
| Comportement de sécurité | Le fournisseur règle les refus et exécute des filtres de contenu | Vous choisissez le modèle, conservez son réglage de sécurité et ajoutez des modèles de garde |
| Abus et coût | Le fournisseur limite le débit et vous facture | Vous plafonnez les tokens et la concurrence, sinon vous perdez de la capacité au lieu d’argent |
| Données d’entraînement | Le fournisseur gère ses propres données | Vous gérez l’empoisonnement, la mémorisation et la suppression pour tout ce sur quoi vous affinez |
Les références OWASP sur lesquelles s’appuyer
L’OWASP mène plusieurs projets sur la sécurité de l’IA. Ils se recoupent, et chacun est plus pertinent pour un type de système différent. Prenez celui qui correspond à ce que vous construisez comme liste de contrôle, et utilisez l’AI Exchange quand vous avez besoin des contrôles détaillés derrière un point.
| Projet | Couvre | À utiliser pour |
|---|---|---|
| Top 10 for LLM Applications 2025 | Dix risques pour les applications bâties sur des modèles de langage, de LLM01 à LLM10 | Chatbots, assistants, RAG et tout produit qui envoie du texte à un LLM |
| Machine Learning Security Top 10 | Dix risques pour les modèles entraînés, de ML01 à ML10, toujours publié comme brouillon | Classifieurs, scoring, fraude, vision et autres modèles prédictifs |
| Top 10 for Agentic Applications 2026 | Dix risques pour les systèmes qui planifient et agissent avec des outils, de ASI01 à ASI10 | Agents, serveurs MCP, workflows multi-agents et exécution de code |
| AI Exchange | Un catalogue complet des menaces et contrôles IA, aligné sur les travaux ISO et de l’AI Act européen | Retrouver le contrôle concret derrière n’importe quel point des Top 10 |
| LLM AI Cybersecurity and Governance Checklist | Questions de gouvernance, de droit, d’inventaire et de déploiement | Validation et revue avant qu’un modèle passe en production |
Partez du type de modèle que vous exécutez
Un classifieur de fraude et un agent de programmation partagent un GPU et une chaîne d’approvisionnement, mais presque rien d’autre. Déterminez quelles lignes ci-dessous vous concernent, car un système correspond souvent à plusieurs. Un chatbot de support avec recherche documentaire et un outil de tickets est à la fois un chatbot, un système RAG et un agent, et il hérite des risques des trois.
| Type | Exemples | Principaux risques | Liste OWASP principale |
|---|---|---|---|
| Modèle prédictif | Scoring de fraude, classification d’images, détection d’anomalies | Évasion, empoisonnement, inversion de modèle, inférence d’appartenance, vol de modèle | ML Security Top 10 |
| Générateur de médias | Modèles d’images par diffusion, synthèse vocale, clonage de voix, vidéo | Contenu nuisible ou illégal, usurpation d’identité, images d’entraînement mémorisées | LLM Top 10 et AI Exchange |
| Modèle de langage | LLM à poids ouverts servis en interne ou derrière une API | Réglage de sécurité faible, épuisement des ressources, divulgation des données d’entraînement | LLM Top 10 |
| Chatbot | Support client, assistance interne, assistant public | Jailbreaks, fuite du prompt système, désinformation, fuites entre utilisateurs | LLM Top 10 |
| Système RAG | Recherche et questions-réponses sur les documents de l’entreprise | Récupération non autorisée, documents empoisonnés, inversion d’embeddings | LLM Top 10 (LLM08) |
| Agent | Agents de programmation, automatisation de workflows, assistants dotés d’outils | Détournement d’objectif, mauvais usage d’outils, abus de privilèges, exécution de code, empoisonnement de la mémoire | Agentic Top 10 |
Traitez les poids téléchargés comme du code non fiable
Un fichier de modèle n’est pas qu’une suite de nombres. Le format pickle de PyTorch, encore courant dans les fichiers .bin, .pt et .pth, peut exécuter du Python arbitraire au chargement. Des chercheurs ont trouvé sur les plateformes publiques de nombreux modèles malveillants qui ouvrent un reverse shell au chargement, et certains étaient conçus pour échapper aux scanners de ces plateformes. L’OWASP classe ce risque en LLM03 Supply Chain et ML06 AI Supply Chain Attacks.
- Ne chargez que du safetensors. Ce format contient des tenseurs et des métadonnées et ne peut pas exécuter de code. Refusez les fichiers pickle en production, et convertissez ceux qui sont fiables dans une tâche isolée.
- N’activez jamais trust_remote_code. Cette option exécute les fichiers Python livrés dans le dépôt du modèle. Si un modèle en a besoin, lisez le code et intégrez-le dans votre propre dépôt.
- Figez la révision exacte. Téléchargez par hash de commit et non par nom de branche, pour qu’un push ultérieur sur le dépôt ne puisse pas changer ce que vous déployez.
- Gardez le chargement weights_only activé. PyTorch 2.6 a fait de weights_only=True la valeur par défaut de torch.load. Ne le désactivez pas, et passez au-delà de la version 2.5.1, qui avait un contournement suivi sous CVE-2025-32434.
- Faites un miroir et analysez. Récupérez les modèles dans un registre interne, analysez-les là avec ModelScan ou un outil équivalent, et n’autorisez les nœuds de production à télécharger que depuis ce registre.
# Commit hash from the model page, never "main"
REVISION=3f1c2a9e7b5d4c8f0a6e2b1d9c7f5a3e1b0d8c6a

hf download meta-llama/Llama-3.1-8B-Instruct \
  --revision "$REVISION" \
  --include "*.safetensors" "*.json" "tokenizer.model" \
  --local-dir ./models/llama-3.1-8b-instruct

# Fail the pipeline on any unsafe operator or pickle file
modelscan --path ./models/llama-3.1-8b-instructSignez ce que vous approuvez
Une analyse vous dit qu’un fichier semble sûr à un instant donné. Une signature permet à chaque étape suivante de prouver qu’il s’agit du même fichier. Une fois un modèle validé, enregistrez un hash de chaque fichier, signez ce manifeste, et faites vérifier la signature par l’étape de déploiement avant que le serveur ne charge quoi que ce soit. Le projet OpenSSF model signing met ce schéma en œuvre pour les modèles. Cosign et un manifeste de sommes de contrôle offrent la même garantie avec des outils que vous utilisez peut-être déjà.
# Approval job
cd models/llama-3.1-8b-instruct
find . -type f ! -name 'MANIFEST*' -print0 | sort -z | xargs -0 sha256sum > MANIFEST.sha256
cosign sign-blob --yes --bundle MANIFEST.bundle MANIFEST.sha256

# Deploy job, before the inference server starts
cosign verify-blob MANIFEST.sha256 --bundle MANIFEST.bundle \
  --certificate-identity "https://github.com/acme/ml-registry/.github/workflows/approve.yml@refs/heads/main" \
  --certificate-oidc-issuer "https://token.actions.githubusercontent.com"
sha256sum --check --strict MANIFEST.sha256Des portes dérobées qu’aucun scanner ne trouvera
Un format de fichier propre ne garantit pas un modèle propre. Des poids peuvent contenir une porte dérobée qui laisse le modèle se comporter normalement jusqu’à l’apparition d’une phrase ou d’un motif d’image déclencheur, et les dérivés affinés de modèles populaires sont un endroit facile pour en cacher une. L’OWASP couvre ce risque en LLM04 Data and Model Poisoning, ML07 Transfer Learning Attack et ML10 Model Poisoning. Préférez les modèles de l’éditeur d’origine ou d’une organisation de confiance, lisez la fiche du modèle et sa licence, tenez un inventaire avec la source et le hash de chaque modèle exécuté, et évaluez un nouveau modèle sur votre propre jeu de test avant qu’il ne remplace l’ancien.
Verrouillez le serveur d’inférence
La plupart des serveurs de modèles ont été conçus pour des chercheurs sur un réseau de confiance. Ollama n’a aucune authentification, et les scans d’Internet trouvent régulièrement des milliers d’instances liées à 0.0.0.0 où n’importe qui peut exécuter, télécharger ou supprimer des modèles. Une traversée de répertoire dans Ollama, CVE-2024-37032, permettait l’exécution de code à distance sur les hôtes exposés. L’API Jobs de Ray, utilisée par de nombreux clusters d’entraînement et de service, accepte des tâches non authentifiées par conception, et la campagne ShadowRay de 2024 l’a utilisée pour prendre le contrôle de clusters GPU. NVIDIA Triton et vLLM ont tous deux connu des avis critiques dans des composants qui acceptent des entrées réseau.
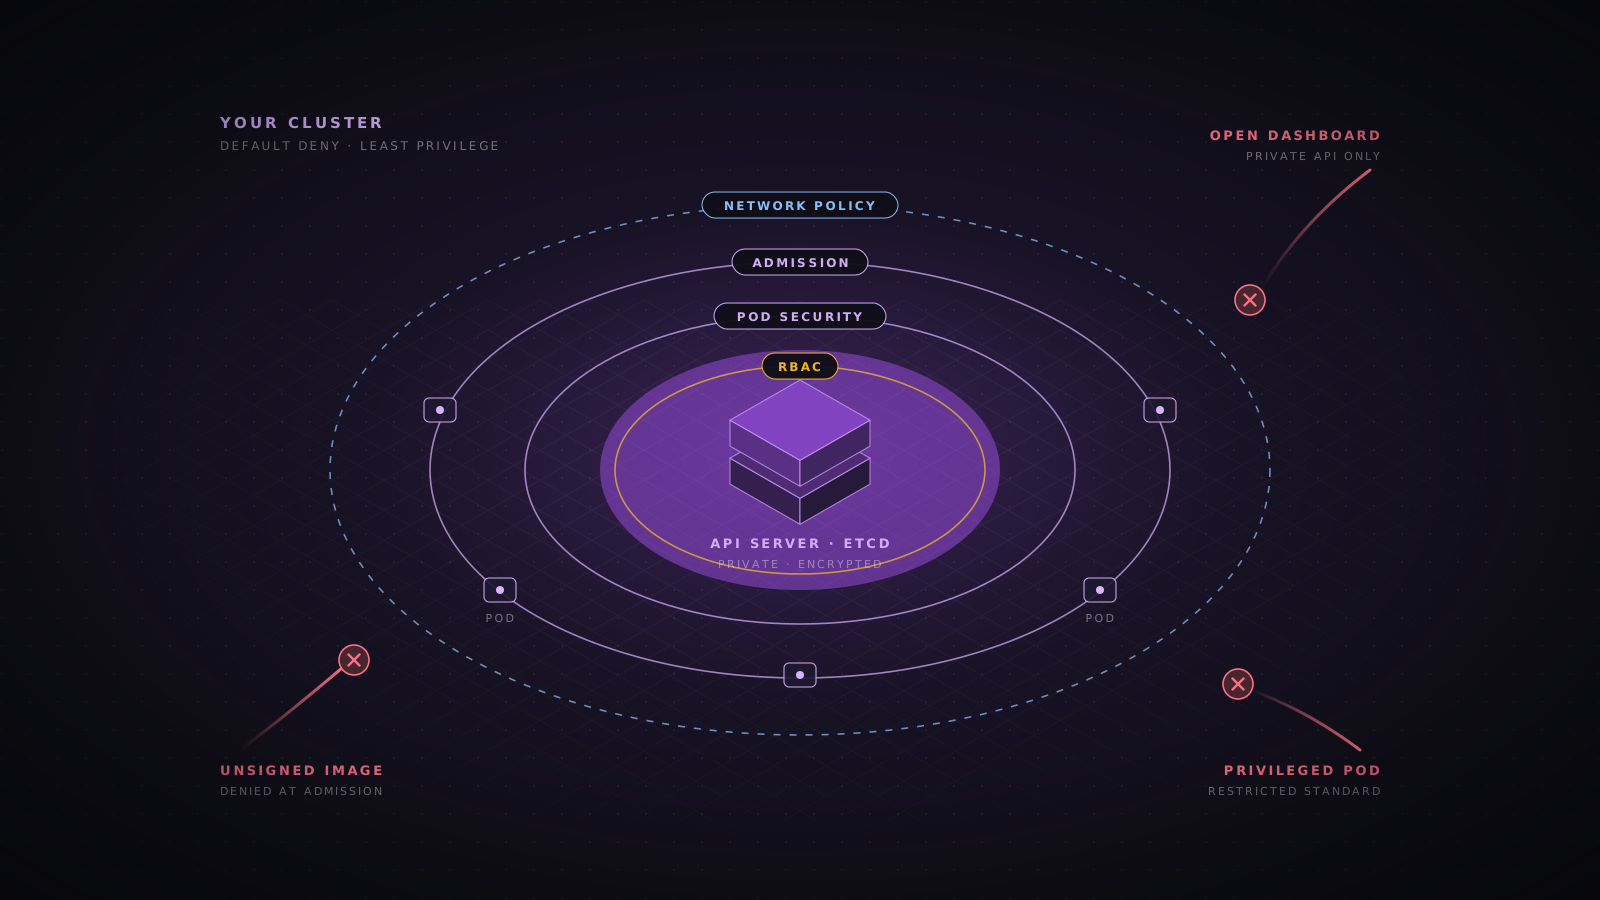
- Liez-le à localhost ou à une interface privée. Le serveur de modèle ne doit jamais être joignable depuis Internet, et dans la plupart des cas pas non plus depuis le reste du réseau de l’entreprise.
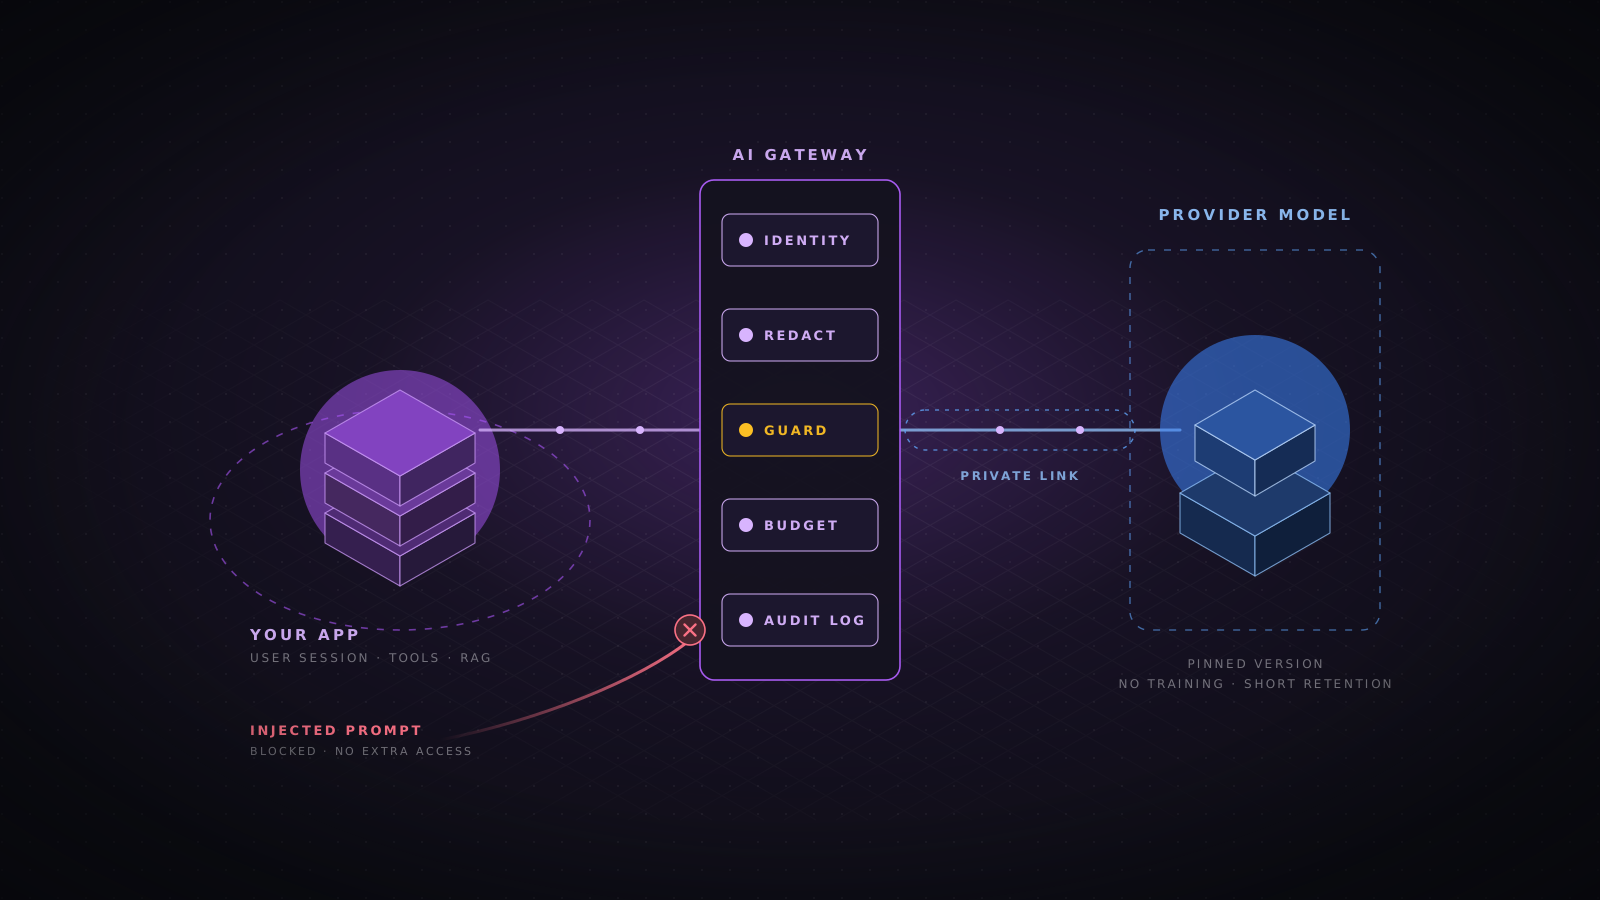
- Placez un proxy authentifiant devant. Votre passerelle ou votre reverse proxy vérifie l’identité, la taille de la requête et le débit avant que quoi que ce soit n’atteigne le modèle.
- N’exposez que les routes d’inférence. Bloquez les points de gestion des modèles, comme pull, delete, load et metrics, pour les appelants qui ne sont pas des opérateurs.
- Corrigez selon un calendrier. Suivez les avis de sécurité du serveur, de ses dépendances Python et de la pile CUDA, et reconstruisez les images quand ils changent.
- Exécutez sans privilège. Utilisez un utilisateur non root, un système de fichiers racine en lecture seule et un montage en lecture seule pour les poids.
vllm serve ./models/llama-3.1-8b-instruct \
  --served-model-name assistant \
  --host 127.0.0.1 --port 8000 \
  --api-key "$VLLM_API_KEY" \
  --max-model-len 8192 \
  --max-num-seqs 32 \
--generation-config vllmlimit_req_zone $binary_remote_addr zone=llm:10m rate=10r/s;
server {
listen 443 ssl;
server_name llm.internal.example.com;
client_max_body_size 256k;
location = /v1/chat/completions {
auth_request /_auth;
limit_req zone=llm burst=20 nodelay;
proxy_read_timeout 120s;
proxy_pass http://127.0.0.1:8000;
}
location = /_auth {
internal;
proxy_pass http://127.0.0.1:9000/verify;
proxy_pass_request_body off;
proxy_set_header Content-Length "";
}
location / { return 404; }
}Hôtes GPU, isolation et vol des poids
Les poids que vous avez affinés sur des données de l’entreprise sont à la fois un actif et un stockage de données. L’OWASP classe le vol du modèle en ML05 Model Theft, et un attaquant qui en possède une copie peut aussi l’étudier hors ligne pour préparer des attaques contre votre système en production. Protégez les poids comme une base de données de production, et concevez les hôtes pour qu’un processus d’inférence compromis ne puisse rien atteindre d’autre.
- Isolez la charge de travail. Exécutez l’inférence sur un pool de nœuds ou des hôtes dédiés, sans autres clients, et sans accès aux données d’entraînement ni au chemin d’écriture du registre de modèles.
- Choisissez délibérément le partage du GPU. NVIDIA MIG partitionne la mémoire et le cache au niveau matériel. Le time slicing et MPS n’offrent pas la même isolation, ne les utilisez donc jamais entre des clients qui ne doivent pas se voir.
- Pensez aux fuites de mémoire GPU. LeftoverLocals, CVE-2023-4969, a montré que certains GPU Apple, AMD, Qualcomm et Imagination permettent à un processus de lire la mémoire laissée par un autre, y compris des sorties de modèle.
- Chiffrez et restreignez les poids. Chiffrez le volume ou le bucket, n’accordez la lecture qu’à l’identité de service, et alertez sur les lectures massives ou les copies venant d’ailleurs.
- Bloquez le trafic sortant. Un pod d’inférence doit répondre aux requêtes, pas ouvrir des connexions. Bloquez le trafic sortant pour qu’un serveur compromis ne puisse pas exfiltrer des poids ou des prompts.
- Envisagez l’informatique confidentielle. Pour des modèles de grande valeur sur du matériel cloud partagé, des GPU comme le H100 proposent un mode d’informatique confidentielle qui chiffre les données en cours d’utilisation.
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
  name: llm-inference-isolation
  namespace: llm-serving
spec:
  podSelector:
    matchLabels:
      app: vllm
  policyTypes: [Ingress, Egress]
  ingress:
    - from:
        - namespaceSelector:
            matchLabels:
              kubernetes.io/metadata.name: ai-gateway
      ports:
        - protocol: TCP
          port: 8000
egress: []Modèles prédictifs et apprentissage automatique classique
Les classifieurs et les modèles de scoring ne discutent pas, mais ils prennent des décisions qui intéressent les attaquants : accepter ou bloquer un paiement, signaler ou laisser passer une connexion, accepter ou rejeter un document. Le Machine Learning Security Top 10 de l’OWASP est ici la liste de référence. Ses attaques se répartissent en trois groupes : tromper le modèle à l’inférence, le corrompre pendant l’entraînement, et apprendre des informations privées à partir de ses réponses.
| Risque | À quoi cela ressemble | Principaux contrôles |
|---|---|---|
| ML01 Input Manipulation | De petites modifications d’une entrée inversent le résultat, comme une transaction retouchée qui passe les contrôles de fraude | Entraînement adversarial, validation des entrées, ensembles de modèles, règles qui ne dépendent pas du seul modèle |
| ML02 Data Poisoning | Des enregistrements forgés dans les données d’entraînement déplacent le modèle ou y implantent un déclencheur | Provenance des données, contrôle d’accès aux jeux de données, détection des valeurs aberrantes avant chaque entraînement |
| ML03 Model Inversion | Des requêtes répétées reconstruisent des caractéristiques des enregistrements d’entraînement, comme des visages | Renvoyer des étiquettes plutôt que des scores bruts, limites de débit, confidentialité différentielle |
| ML04 Membership Inference | Un attaquant apprend si une personne figurait dans le jeu d’entraînement | Régularisation, confidentialité différentielle, valeurs de confiance grossières |
| ML05 Model Theft | Les poids sont copiés, ou le modèle est cloné à partir de ses propres réponses | Protection des poids, budgets de requêtes, surveillance des sondages systématiques |
| ML06 AI Supply Chain Attacks | Bibliothèques, modèles préentraînés ou jeux de données compromis | Dépendances figées et analysées, modèles signés, miroirs internes |
| ML07 Transfer Learning Attack | Une porte dérobée dans un modèle de base survit à l’affinage | Modèles de base de confiance, évaluation sur vos propres jeux de test et de déclencheurs |
| ML08 Model Skewing | Des attaquants alimentent la boucle de rétroaction pour que le réentraînement dérive en leur faveur | Valider les données de rétroaction, plafonner le poids de chaque source, examiner la dérive |
| ML09 Output Integrity Attack | Les résultats sont modifiés entre le modèle et le système qui les utilise | Transport authentifié et signé entre services, contrôles d’intégrité |
| ML10 Model Poisoning | Les poids sont modifiés directement pour changer le comportement | Écriture réservée à la chaîne d’entraînement, artefacts signés, vérification des hash au chargement |
Beaucoup de ces attaques ont besoin de scores très précis et de nombreuses requêtes. La défense la moins chère consiste à ne renvoyer que ce dont l’appelant a besoin : une décision, ou une confiance arrondie à une valeur grossière, jamais le vecteur de probabilités complet. Combinez cela avec des budgets de requêtes par client et une alerte pour les clients qui envoient beaucoup d’entrées presque identiques, ce qui est la signature du trafic d’extraction et d’inversion.
from pydantic import BaseModel

DECISION_THRESHOLD = 0.8
SCORE_STEP = 0.1

class FraudVerdict(BaseModel):
    decision: str
    score: float

def verdict(probabilities: list[float]) -> FraudVerdict:
    fraud = probabilities[1]
    coarse = round(round(fraud / SCORE_STEP) * SCORE_STEP, 1)
    return FraudVerdict(decision="review" if fraud >= DECISION_THRESHOLD else "allow", score=coarse)
Quand le modèle est entraîné sur des données personnelles, la confidentialité différentielle fixe une limite mesurable à ce que chaque enregistrement peut apporter, ce qui affaiblit directement l’inférence d’appartenance et l’inversion. Elle coûte un peu de précision, testez-la donc sur vos propres données. Des bibliothèques comme Opacus pour PyTorch l’ajoutent à une boucle d’entraînement existante.
from opacus import PrivacyEngine

privacy_engine = PrivacyEngine()
model, optimizer, train_loader = privacy_engine.make_private_with_epsilon(
    module=model,
    optimizer=optimizer,
    data_loader=train_loader,
    epochs=EPOCHS,
    target_epsilon=8.0,
    target_delta=1e-5,
    max_grad_norm=1.0,
)Générateurs d’images, d’audio et de vidéo
Pour les médias génératifs, le risque principal est ce que le modèle produit, pas ce qu’il divulgue. Un modèle d’images ou de voix autohébergé privé de ses protections peut produire des images intimes non consenties, des contenus pédocriminels, des clones de voix prêts pour la fraude et de fausses preuves. Si c’est votre serveur, c’est votre production, juridiquement et dans la presse. Les fournisseurs hébergés font tourner des filtres de prompts, des classifieurs de sortie et des équipes anti-abus. Il vous faut votre propre version de chacun.
- Gardez le safety checker. Les pipelines de diffusion sont livrés avec un safety checker que de nombreux tutoriels conseillent de désactiver. Laissez-le actif, et ajoutez un classifieur de sortie dédié aux catégories qui comptent pour vous.
- Filtrez les prompts et les sorties. Contrôlez le prompt avant la génération et l’image ou l’audio après. Le filtrage du prompt seul se contourne facilement avec des fautes d’orthographe et d’autres langues.
- Bloquez les personnes réelles par défaut. Refusez les requêtes qui nomment des personnes réelles ou envoient un échantillon de visage ou de voix, sauf si la fonctionnalité repose sur un processus de consentement.
- Contrôlez les extensions. Les adaptateurs LoRA, les embeddings et les checkpoints personnalisés modifient le comportement du modèle et peuvent être du code pickle. Appliquez-leur les mêmes règles de chaîne d’approvisionnement qu’aux poids de base.
- Marquez ce que vous générez. Attachez des content credentials C2PA, et ajoutez un filigrane invisible quand votre modèle le permet, pour que vos productions puissent être identifiées plus tard.
- Surveillez la mémorisation. Les modèles de diffusion peuvent reproduire presque à l’identique des images d’entraînement. Si vous affinez sur des images privées ou sous licence, testez la présence de quasi-doublons avant la mise en service.
Les modèles de langage que vous servez vous-même
Un LLM à poids ouverts n’est sûr que dans la mesure de son réglage, et ce réglage se perd facilement. Des travaux publiés en 2023 par Qi et ses collègues ont montré qu’affiner un modèle aligné sur un petit ensemble d’exemples, même inoffensifs, peut supprimer une grande partie de son comportement de refus. Les variantes abliterated et uncensored des plateformes publiques ont vu leurs refus supprimés volontairement. Si vous affinez, vous devez mesurer de nouveau la sécurité ensuite, car elle aura changé.
- Prenez le modèle instruct de l’éditeur d’origine. C’est celui qui a reçu le plus de travail de sécurité. Évitez les fusions communautaires et les variantes uncensored pour tout ce que des utilisateurs peuvent atteindre.
- Ajoutez un modèle de garde. Faites passer l’entrée et la sortie dans un classifieur comme Llama Guard, ShieldGemma ou Granite Guardian. C’est un modèle distinct, donc un jailbreak contre le modèle principal ne le désactive pas.
- Relancez les évaluations après chaque affinage. Utilisez les mêmes tests de refus et de jailbreak que sur le modèle de base, et ne livrez pas si les résultats se dégradent.
- Protégez le jeu d’entraînement. Un modèle affiné sur des tickets, des e-mails ou du code peut les répéter mot pour mot. C’est le risque LLM02 Sensitive Information Disclosure. Retirez les secrets et les données personnelles avant l’entraînement, et testez la restitution à l’identique.
- Bornez chaque requête. LLM10 Unbounded Consumption sur votre propre matériel signifie que quelques prompts longs peuvent occuper toute la mémoire GPU. Plafonnez la longueur de contexte, les tokens de sortie, les séquences simultanées et la durée des requêtes.
from openai import OpenAI

guard = OpenAI(base_url="http://127.0.0.1:8001/v1", api_key=GUARD_API_KEY)

def is_safe(conversation: list[dict[str, str]]) -> bool:
    result = guard.chat.completions.create(
        model="llama-guard",
        messages=conversation,
        max_tokens=20,
        temperature=0,
    )
    verdict = (result.choices[0].message.content or "").strip().lower()
    return verdict.startswith("safe")

# Check the user turn before generation, then the full exchange after it
if not is_safe([{"role": "user", "content": user_text}]):
raise RefusedRequest("input")Chatbots et assistants
Un chatbot place un modèle de langage face à des personnes qui essaieront de le faire dérailler. Ces risques sont le cœur du LLM Top 10 de l’OWASP, et ils ne diminuent pas parce que le modèle tourne sur votre matériel. L’autohébergement vous donne cependant plus de contrôle ici, puisque vous pouvez changer le modèle, la garde et la journalisation sans attendre un fournisseur.
- LLM01 Prompt Injection. Des utilisateurs tenteront de passer outre vos instructions. Gardez les instructions dans le rôle système, filtrez l’entrée avec un modèle de garde, et ne laissez jamais la conversation décider des données ou des actions auxquelles l’utilisateur a droit.
- LLM07 System Prompt Leakage. Partez du principe que le prompt système sera réaffiché à un utilisateur. Il peut décrire le ton et le périmètre, mais ne doit contenir ni identifiants, ni noms d’hôtes internes, ni règles d’accès.
- LLM05 Improper Output Handling. Affichez les réponses en texte ou en Markdown nettoyé, et bloquez les images distantes et les liens inconnus, qui peuvent servir à faire sortir des données de la page.
- LLM09 Misinformation. Le bot affirmera des choses fausses avec assurance. En 2024, un tribunal canadien a tenu Air Canada responsable des conditions de remboursement inventées par son chatbot, dans l’affaire Moffatt v. Air Canada. Ancrez les réponses dans votre propre contenu, affichez les sources, et orientez les questions de politique, de prix et de droit vers des réponses fixes ou un humain.
- Isolation des conversations. Stockez l’historique par utilisateur et par session, indexé sur l’identité authentifiée, et ne réutilisez jamais une conversation comme contexte pour un autre utilisateur. Un cache de prompts partagé ne doit pas non plus fuir entre clients.
- Abus et conservation. Limitez le débit par utilisateur, enregistrez les tentatives de jailbreak, et ne gardez les transcriptions que le temps nécessaire, dans un stockage doté de son propre contrôle d’accès.
Génération augmentée par récupération
La recherche documentaire donne vos documents au modèle, ce qui le rend utile et en fait un chemin vers des données que l’utilisateur ne devrait pas voir. L’OWASP couvre ce risque en LLM08 Vector and Embedding Weaknesses. La règle est la même que pour tout accès aux données : la requête de recherche applique les permissions de l’utilisateur, avec des valeurs issues de la session et jamais du modèle.
from qdrant_client import QdrantClient, models

client = QdrantClient(url="http://qdrant.internal:6333", api_key=QDRANT_API_KEY)

def search(session: Session, query_vector: list[float]) -> list[models.ScoredPoint]:
    access = models.Filter(must=[
        models.FieldCondition(key="tenant_id", match=models.MatchValue(value=session.tenant_id)),
        models.FieldCondition(key="groups", match=models.MatchAny(any=session.group_ids)),
    ])
    return client.query_points(
        collection_name="documents",
        query=query_vector,
        query_filter=access,
        limit=8,
).points- Traitez les documents comme des entrées non fiables. Quiconque peut écrire dans une source indexée, comme une page wiki, un ticket ou un dossier partagé, peut y placer des instructions que le modèle lira. Marquez le texte récupéré comme des données dans le prompt, et ne donnez pas à un chatbot RAG d’outils qui écrivent ou envoient.
- Contrôlez ce qui est indexé. N’indexez que des sources approuvées, enregistrez l’origine de chaque fragment, et retirez le texte caché, les commentaires et les métadonnées à l’ingestion.
- Protégez la base vectorielle. Les embeddings peuvent être partiellement inversés pour retrouver le texte. Donnez à la base une authentification, un chiffrement et la même classification que les documents sources.
- Gardez les permissions synchronisées. Quand un document est supprimé ou que son partage change, mettez à jour ou supprimez ses fragments, sinon la recherche devient un moyen de lire un contenu révoqué.
Agents et usage d’outils
Un agent transforme la sortie du modèle en actions : il lit des fichiers, appelle des API, exécute du code et dialogue avec d’autres agents. Une injection réussie cesse alors d’être une mauvaise réponse et devient un vrai changement dans un vrai système. Le Top 10 for Agentic Applications 2026 de l’OWASP, publié par l’OWASP GenAI Security Project en décembre 2025, est écrit pour ce cas. Les agents autohébergés reçoivent souvent plus d’accès que les agents hébergés, car ils tournent à l’intérieur du réseau, ces contrôles comptent donc encore plus.
| Risque | Principaux contrôles |
|---|---|
| ASI01 Agent Goal Hijack | Traiter tout contenu récupéré ou issu d’outils comme des données, garder les objectifs dans une configuration fixe, faire confirmer les actions à fort impact par un humain |
| ASI02 Tool Misuse and Exploitation | Jeu d’outils minimal par tâche, schémas d’arguments stricts, destinations sur liste blanche, limites de débit par outil |
| ASI03 Identity and Privilege Abuse | Les outils agissent avec les permissions de l’utilisateur final, identifiants à courte durée et à portée limitée, aucun compte de service partagé |
| ASI04 Agentic Supply Chain Vulnerabilities | Examiner et figer les serveurs MCP, plugins et modèles de prompts, et les exécuter dans leur propre bac à sable |
| ASI05 Unexpected Code Execution | Exécuter le code généré dans un bac à sable isolé sans réseau ni secrets, jamais avec eval sur l’hôte |
| ASI06 Memory and Context Poisoning | Mémoire séparée par utilisateur, validation de ce qui est écrit en mémoire longue, possibilité de revue et de suppression |
| ASI07 Insecure Inter-Agent Communication | Authentifier et autoriser chaque appel entre agents, signer les messages, ne jamais croire ce qu’un autre agent affirme sur l’utilisateur |
| ASI08 Cascading Failures | Limites d’étapes, de tokens et de dépenses, disjoncteurs entre agents, interrupteur d’arrêt par workflow |
| ASI09 Human-Agent Trust Exploitation | Montrer l’action exacte et son effet avant approbation, et ne pas laisser l’agent rédiger le texte de confirmation |
| ASI10 Rogue Agents | Inventorier chaque agent et ses permissions, journaliser toutes les actions, détecter les comportements hors du périmètre déclaré |
L’exécution de code mérite sa propre frontière. Si un agent peut exécuter du code, partez du principe qu’il exécutera un jour du code écrit par un attaquant. Le bac à sable ne doit avoir ni réseau ni identifiants, une vue en lecture seule de ses entrées, et des limites de temps, de mémoire et de processus. Un noyau en espace utilisateur comme gVisor, ou une microVM comme Firecracker, offre une barrière bien plus solide qu’un simple conteneur.
docker run --rm \
  --runtime=runsc \
  --network none \
  --read-only --tmpfs /tmp:rw,size=64m \
  --cap-drop ALL --security-opt no-new-privileges \
  --pids-limit 128 --memory 512m --cpus 1 \
  --user 65534:65534 \
  -v "$JOB_DIR:/work:ro" \
  python:3.12-slim timeout 30 python /work/main.py
Les serveurs MCP et les plugins d’outils sont du code qui s’exécute avec les accès que vous lui donnez. Installez-les depuis des sources que vous avez examinées, figez leurs versions, donnez à chacun ses propres identifiants limités à une tâche, et exécutez les serveurs locaux dans le même type de bac à sable. Une description d’outil est aussi du texte lu par le modèle, donc un serveur malveillant peut injecter des instructions par ses propres métadonnées.
Testez le modèle comme le ferait un attaquant
Vous ne pouvez pas compter sur la red team d’un fournisseur, alors menez la vôtre. Gardez une suite de tests de sécurité à côté de vos évaluations de qualité et exécutez-la à chaque changement des poids, du prompt système, du modèle de garde, des outils ou de la configuration de service. Testez le système complet tel que les utilisateurs l’atteignent, pas seulement le modèle nu, car la plupart des défaillances viennent de la façon dont les éléments s’assemblent.
- garak sonde un modèle de langage à la recherche de jailbreaks, d’injections de prompt, de fuites de données et de sorties toxiques.
- PyRIT, de Microsoft, automatise des attaques en plusieurs tours contre une application complète.
- promptfoo génère des cas de red team à partir de votre propre configuration et les exécute en CI.
- L’Adversarial Robustness Toolbox teste les modèles prédictifs contre l’évasion, l’empoisonnement, l’inversion et l’extraction.
export OPENAI_API_KEY="$VLLM_API_KEY"
python -m garak \
  --model_type openai.OpenAICompatible \
  --model_name assistant \
  --generator_option_file garak-local.json \
  --probes promptinject,dan,leakreplay,encoding \
--report_prefix nightlySurveillance et réponse aux incidents
Journalisez chaque requête au niveau de la passerelle avec l’utilisateur, le nom et la révision du modèle, le nombre de tokens, les verdicts de garde, les appels d’outils et la latence. Ne conservez les prompts et sorties complets que dans un stockage restreint à courte durée de conservation. Envoyez ces enregistrements, avec les journaux d’audit des hôtes, de Kubernetes et du registre, à votre SIEM.
- Abus. Hausses des tokens par utilisateur, nombreux blocages de garde depuis un même compte, et longues séries de requêtes presque identiques.
- Infrastructure. Nouveaux processus ou connexions sortantes sur les hôtes d’inférence, accès aux routes de gestion des modèles, et modifications de l’image de service.
- Poids. Lectures du bucket de modèles par toute identité autre que le rôle de service, et un hash de modèle au chargement qui ne correspond pas au manifeste signé.
- Agents. Appels d’outils refusés par les contrôles d’autorisation, violations du bac à sable, et actions hors du périmètre déclaré.
Rédigez les procédures avant d’en avoir besoin. Pour un jailbreak ou une sortie nuisible, la première étape est une règle de garde ou un interrupteur de fonctionnalité, pas un réentraînement. Pour un modèle empoisonné ou piégé, revenez à la dernière version signée et trouvez comment la mauvaise est entrée. Pour des poids volés, partez du principe que l’attaquant peut désormais tester des attaques hors ligne, renouvelez tous les secrets que le modèle ou sa chaîne pouvaient atteindre, et examinez quelles données d’entraînement le modèle peut révéler.
Liste de contrôle avant la production
- Inventaire. Chaque modèle est enregistré avec sa source, sa révision, son hash, sa licence, son responsable et les données sur lesquelles il a été affiné.
- Chaîne d’approvisionnement. Les poids sont en safetensors depuis une révision figée, analysés, signés et vérifiés au déploiement.
- Serveur. Le serveur d’inférence est lié à une interface privée, placé derrière un proxy authentifiant, et s’exécute sans root.
- Isolation. L’inférence tourne sur des nœuds dédiés, le partage du GPU est un choix délibéré, et le trafic sortant est bloqué.
- Limites. Longueur de contexte, tokens de sortie, concurrence, durée des requêtes et budgets par utilisateur sont tous définis.
- Sécurité. Un modèle de garde filtre l’entrée et la sortie, et les évaluations de sécurité ont été relancées après tout affinage.
- Données. La recherche filtre selon les permissions de l’utilisateur, et les données d’entraînement ont été nettoyées des secrets et des données personnelles.
- Agents. Les outils agissent en tant qu’utilisateur, le code s’exécute dans un bac à sable sans réseau, et les effets de bord exigent une confirmation.
- Tests. La suite de red team s’exécute en CI à chaque changement de modèle, de prompt, d’outil ou de configuration.
- Réponse. Les journaux arrivent au SIEM, et les procédures de retour arrière, d’interrupteur d’arrêt et de vol des poids ont été testées au moins une fois.
Conclusion
L’autohébergement garde vos données dans votre réseau, mais il ne rend pas le modèle digne de confiance. Vous prenez en charge une chaîne d’approvisionnement de gros fichiers binaires, une pile de service jeune aux réglages par défaut faibles, une infrastructure GPU, et le travail de sécurité qu’un fournisseur aurait fait. Les listes de l’OWASP vous donnent une carte pour chaque type de système : le ML Top 10 pour les modèles prédictifs, le LLM Top 10 pour les modèles de langage, les chatbots et le RAG, et l’Agentic Top 10 dès que le modèle peut agir. Vérifiez ce que vous chargez, gardez le serveur privé, limitez ce que le modèle peut atteindre, et testez-le comme le ferait un attaquant.
Sources
- OWASP Gen AI Security Project, Top 10 for LLM Applications 2025.
- OWASP Gen AI Security Project, Top 10 for Agentic Applications 2026 (décembre 2025).
- OWASP Machine Learning Security Top 10 (brouillon).
- OWASP AI Exchange, owaspai.org.
- OWASP LLM AI Cybersecurity and Governance Checklist.
- Qi et al., « Fine-tuning Aligned Language Models Compromises Safety, Even When Users Do Not Intend To! » (2023).
- Oligo Security, recherche ShadowRay sur CVE-2023-48022 (mars 2024).
- Wiz Research, Probllama, CVE-2024-37032 dans Ollama (juin 2024).
- Trail of Bits, LeftoverLocals, CVE-2023-4969 (janvier 2024).
- Moffatt v. Air Canada, 2024 BCCRT 149.
- Documentation de safetensors, Hugging Face.
- ModelScan, Protect AI.
- Documentation de signature Sigstore cosign.
- OpenSSF model signing (model-transparency).
- Documentation de vLLM.
- Llama Guard 3, Meta PurpleLlama.
- Documentation de Qdrant.
- Documentation de gVisor.
- Opacus, confidentialité différentielle pour PyTorch.
- NVIDIA garak, scanner de vulnérabilités pour LLM.
- Microsoft PyRIT, Python Risk Identification Tool.
- Spécification technique C2PA 2.1.
- Sécurité de l’IA
- IA autohébergée
- OWASP LLM Top 10
- OWASP ML Top 10
- IA agentique
- Chaîne d’approvisionnement des modèles
- vLLM
- Ollama
- RAG
- Chatbots