Sommaire
Introduction
La plupart des équipes qui livrent des fonctions d’IA n’exécutent pas le modèle. Elles envoient des prompts à un fournisseur en HTTPS, soit directement à un éditeur de modèles comme OpenAI, Anthropic ou Google, soit via une plateforme cloud comme Amazon Bedrock, Azure OpenAI ou Vertex AI. Le fournisseur possède les GPU, les poids et la pile de service. Vous restez propriétaire de tout ce qui décide du contenu d’une requête, de qui a le droit de l’envoyer et de ce que votre système fait de la réponse. C’est dans cette seconde moitié que se sont produits presque tous les incidents réels liés à l’IA hébergée jusqu’ici.
Ce guide s’adresse aux ingénieurs qui intègrent un modèle hébergé dans un produit. Il couvre la frontière de confiance dont vous êtes réellement responsable, les identifiants et les chemins réseau, les données qui ne doivent jamais atteindre le prompt, l’injection de prompt et l’usage d’outils, les limites d’abus et de coût, la journalisation, les changements de modèle et la conduite à tenir quand une clé fuit. Chaque section contient une configuration ou du code à adapter.
Où s’arrête le fournisseur et où vous commencez
L’IA hébergée suit le même modèle de responsabilité partagée que tout service cloud managé, mais la ligne se situe plus haut dans la pile que la plupart des équipes ne le pensent. Le fournisseur sécurise le modèle, son hébergement et l’isolation entre clients. Il ne peut pas savoir si le document que vous avez collé dans un prompt devait être visible pour cet utilisateur, ni si un appel d’outil demandé par le modèle doit s’exécuter.
| Couche | Le fournisseur gère | Vous gérez |
|---|---|---|
| Modèle et poids | Données d’entraînement, réglage de sécurité, stockage des poids et accès | Choisir le modèle et figer une version |
| Infrastructure de service | Matériel, isolation entre clients, correctifs, disponibilité | Repli quand le fournisseur est en panne ou lent |
| Accès à l’API | Service d’authentification, mécanique des clés et des rôles, point de terminaison TLS | Stockage des clés, rotation, moindre privilège, qui peut appeler |
| Traitement des données | Rétention, chiffrement au repos, usage pour l’entraînement, région de traitement | Choisir les conditions que vous signez et les données que vous envoyez |
| Contenu du prompt | Rien | Autorisation de chaque document et enregistrement placé dans le contexte |
| Sortie du modèle | Filtres de contenu, lorsqu’ils sont proposés | Validation, encodage et chaque action déclenchée par la sortie |
| Surveillance | Journaux d’audit de la plateforme, lorsqu’ils sont proposés | Journaux applicatifs, détection d’abus, alertes de dépenses |
Un modèle de menace pour l’inférence hébergée
L’OWASP Top 10 for LLM Applications (édition 2025) est une bonne liste de contrôle, mais il vaut mieux partir de votre propre architecture. Dessinez le chemin de la requête de l’utilisateur au fournisseur et retour, marquez chaque endroit où du texte non fiable entre, et chaque endroit où la sortie du modèle déclenche quelque chose. Les menaces ci-dessous couvrent l’essentiel de ce que ce schéma montrera.
- Vol d’identifiants. Une clé d’API dans un dépôt, un paquet d’application mobile, un bundle navigateur ou un journal de CI permet à n’importe qui de consommer votre quota et de lire tout ce que votre compte peut atteindre, comme les fichiers stockés, les modèles affinés ou les sorties de lots.
- Divulgation de données sensibles. Des données personnelles, des secrets ou les enregistrements d’un autre client sont placés dans un prompt, puis conservés par le fournisseur, écrits dans vos propres journaux ou renvoyés au mauvais utilisateur.
- Injection de prompt. Des instructions cachées dans la saisie de l’utilisateur, des pages web, des e-mails ou des documents récupérés changent ce que fait le modèle, y compris les outils qu’il appelle et ce qu’il envoie à l’extérieur.
- Autonomie excessive. Le modèle reçoit des outils avec plus de permissions que l’utilisateur courant, si bien qu’une injection réussie devient une vraie écriture, suppression, un paiement ou un e-mail.
- Traitement incorrect des sorties. La sortie du modèle est rendue en HTML, en Markdown avec images distantes, ou passée à SQL ou au shell sans encodage ni validation.
- Consommation illimitée. De gros prompts, de longues sorties ou du trafic scripté font grimper le coût ou épuisent les limites de débit, un schéma souvent appelé déni de portefeuille.
- Chaîne d’approvisionnement et dérive. Un alias de modèle passe à une nouvelle version, un SDK ou un plugin est compromis, ou un fournisseur change ses conditions de données, et le comportement change sans déploiement de votre côté.
- Compromission ou panne du fournisseur. Une violation ou une longue panne chez le fournisseur. Vous ne pouvez pas l’empêcher, vous la préparez donc avec la minimisation des données et un repli.
Lire les conditions de données avant la documentation
Le réglage de sécurité le plus important d’un modèle hébergé n’est pas dans l’API. Il se trouve dans le contrat et les paramètres du compte, et il décide du sort de chaque prompt envoyé. Obtenez des réponses écrites à ces questions pour le niveau de produit exact que vous utiliserez, car les applications grand public, les offres entreprise et l’accès API d’un même éditeur ont souvent des conditions différentes.
- Usage pour l’entraînement. Les entrées et sorties de l’API servent-elles par défaut à entraîner ou améliorer les modèles ? La plupart des offres entreprise et API disent non, mais vérifiez-le dans le contrat, pas dans un billet de blog.
- Rétention. Combien de temps les prompts et les réponses sont-ils stockés, et dans quel but ? Beaucoup de fournisseurs les gardent pendant une période limitée, souvent autour de 30 jours, pour la surveillance des abus. Demandez si une rétention nulle ou une exemption de surveillance est possible et ce qu’elle exige.
- Revue humaine. Dans quelles conditions le personnel du fournisseur peut-il lire vos prompts, par exemple quand des classificateurs d’abus signalent une requête ?
- Fonctions avec état. Fichiers, assistants, fils de discussion, bases vectorielles, caches et traitements par lots sont stockés côté fournisseur. Ils échappent généralement à la rétention nulle et nécessitent leur propre processus de suppression.
- Région. Où l’inférence est-elle traitée et où les données sont-elles stockées ? Les points de terminaison globaux peuvent router une requête vers n’importe quelle région pour trouver de la capacité, ce qui compte au regard du RGPD et des règles sectorielles.
- Assurance. Vérifiez la présence d’un rapport SOC 2 Type II à jour, de l’ISO/IEC 27001 et de l’ISO/IEC 42001 pour le management de l’IA. Lisez la liste des sous-traitants et la clause de notification de violation.
API directe de l’éditeur ou plateforme cloud
Beaucoup de modèles de pointe sont disponibles à la fois directement chez l’éditeur et via un hyperscaler. Le modèle peut être le même, mais les contrôles de sécurité autour ne le sont pas. Appeler un modèle depuis votre compte cloud existant permet de réutiliser les contrôles d’identité, de réseau et de journalisation que vous exploitez déjà, ce qui est souvent décisif pour les charges réglementées.
| Contrôle | API directe de l’éditeur | Amazon Bedrock | Azure OpenAI | Vertex AI |
|---|---|---|---|---|
| Authentification | Clés d’API, limitées par organisation, projet ou espace de travail | Rôles et politiques IAM | Entra ID avec identités managées, ou clés d’API | IAM avec comptes de service |
| Chemin réseau privé | En général internet public uniquement | Point de terminaison VPC d’interface (PrivateLink) | Point de terminaison privé | Private Service Connect et VPC Service Controls |
| Audit du plan de contrôle | Journaux de la console d’administration de l’éditeur | CloudTrail | Journal d’activité Azure | Cloud Audit Logs |
| Journalisation des requêtes | Votre application uniquement | Journalisation des invocations de modèle vers S3 ou CloudWatch | Paramètres de diagnostic vers Log Analytics | Journalisation des requêtes et réponses vers BigQuery |
| Résidence des données | Selon l’éditeur et l’offre | Régionale, avec inférence interrégionale en option | Déploiements régionaux, globaux ou par zone de données | Régionale, avec point de terminaison global en option |
L’API directe reçoit souvent les nouveaux modèles et fonctions en premier. La plateforme cloud l’emporte généralement sur le réseau privé et l’identité. Si vous utilisez les deux, placez-les derrière la même passerelle interne, décrite plus bas, afin que la politique ne dépende pas du chemin emprunté par une requête.
Identifiants : pas de clés à longue durée de vie dans vos applications
Une clé d’API de modèle est un jeton porteur pour votre facture et pour toutes les données stockées dans le compte. Traitez-la comme un mot de passe de base de données. Ne la livrez jamais dans un navigateur ou une application mobile, où elle peut être extraite en quelques minutes. Les applications clientes appellent votre backend, et seul le backend parle au fournisseur.
Sur une plateforme cloud, oubliez les clés et utilisez l’identité de charge de travail. Accordez au rôle du service le droit d’invoquer uniquement les modèles dont il a besoin, dans les régions nécessaires, et uniquement via votre point de terminaison privé.
{
  "Version": "2012-10-17",
  "Statement": [
    {
      "Sid": "InvokePinnedModels",
      "Effect": "Allow",
      "Action": [
        "bedrock:InvokeModel",
        "bedrock:InvokeModelWithResponseStream"
      ],
      "Resource": [
        "arn:aws:bedrock:eu-west-1::foundation-model/anthropic.claude-sonnet-4-5-20250929-v1:0",
        "arn:aws:bedrock:eu-west-1::foundation-model/amazon.titan-embed-text-v2:0"
      ],
      "Condition": {
        "StringEquals": { "aws:SourceVpce": "vpce-0a1b2c3d4e5f67890" }
      }
    }
  ]
}# Give the app's managed identity data-plane access to one resource
az role assignment create \
--assignee-object-id "$APP_PRINCIPAL_ID" \
--assignee-principal-type ServicePrincipal \
--role "Cognitive Services OpenAI User" \
--scope "/subscriptions/$SUB/resourceGroups/rg-ai/providers/Microsoft.CognitiveServices/accounts/aoai-prod"
# Turn off key authentication so a leaked key is worthless
az resource update \
--ids "/subscriptions/$SUB/resourceGroups/rg-ai/providers/Microsoft.CognitiveServices/accounts/aoai-prod" \
--set properties.disableLocalAuth=trueQuand l’éditeur ne propose que des clés d’API, limitez les dégâts qu’une seule clé peut causer. Créez une clé par service et par environnement, limitez-la à un projet ou espace de travail qui ne contient rien d’autre, fixez une limite de dépenses sur ce projet et gardez la clé dans un gestionnaire de secrets qui l’injecte à l’exécution. Faites la rotation selon un calendrier et à chaque départ d’un membre de l’équipe qui peut la lire. Activez l’analyse de secrets avec blocage à l’envoi dans votre hébergeur de code, et analysez l’historique une fois, car les anciens commits sont l’endroit où les clés se cachent.
# Scans every commit; --redact keeps found secrets out of the output
gitleaks detect --source . --redact -v

# Quick manual check for common key prefixes in the working tree
git grep -nE 'sk-(proj|ant|svcacct)-[A-Za-z0-9_-]{20,}|AIza[0-9A-Za-z_-]{35}'Chemins réseau et contrôle des sorties
Les points de terminaison privés gardent le trafic des modèles hors de l’internet public et permettent de refuser tout autre chemin. Sur AWS, créez un point de terminaison d’interface pour le runtime Bedrock et associez-lui une politique ; sur Azure, ajoutez un point de terminaison privé et désactivez l’accès réseau public ; sur Google Cloud, placez Vertex AI dans un périmètre VPC Service Controls pour que les données ne puissent pas être envoyées vers un projet extérieur.
aws ec2 create-vpc-endpoint \
  --vpc-id vpc-0123456789abcdef0 \
  --vpc-endpoint-type Interface \
  --service-name com.amazonaws.eu-west-1.bedrock-runtime \
  --subnet-ids subnet-0aaa1111 subnet-0bbb2222 \
  --security-group-ids sg-0ccc3333 \
  --private-dns-enabled
Les API directes des éditeurs sont des points de terminaison publics, contrôlez donc l’autre côté : les sorties de vos charges de travail. Faites passer le trafic sortant par un proxy qui n’autorise que les noms d’hôte des fournisseurs que vous utilisez. Cela empêche un service compromis d’appeler le point de terminaison de modèle d’un attaquant avec vos données, et rend visible toute nouvelle dépendance IA, puisqu’elle échoue tant que personne ne l’ajoute.
acl llm_apis dstdomain api.openai.com api.anthropic.com generativelanguage.googleapis.com
acl SSL_ports port 443
acl CONNECT method CONNECT

http_access deny CONNECT !SSL_ports
http_access allow CONNECT llm_apis
http_access deny allPlacer une passerelle entre votre code et le modèle
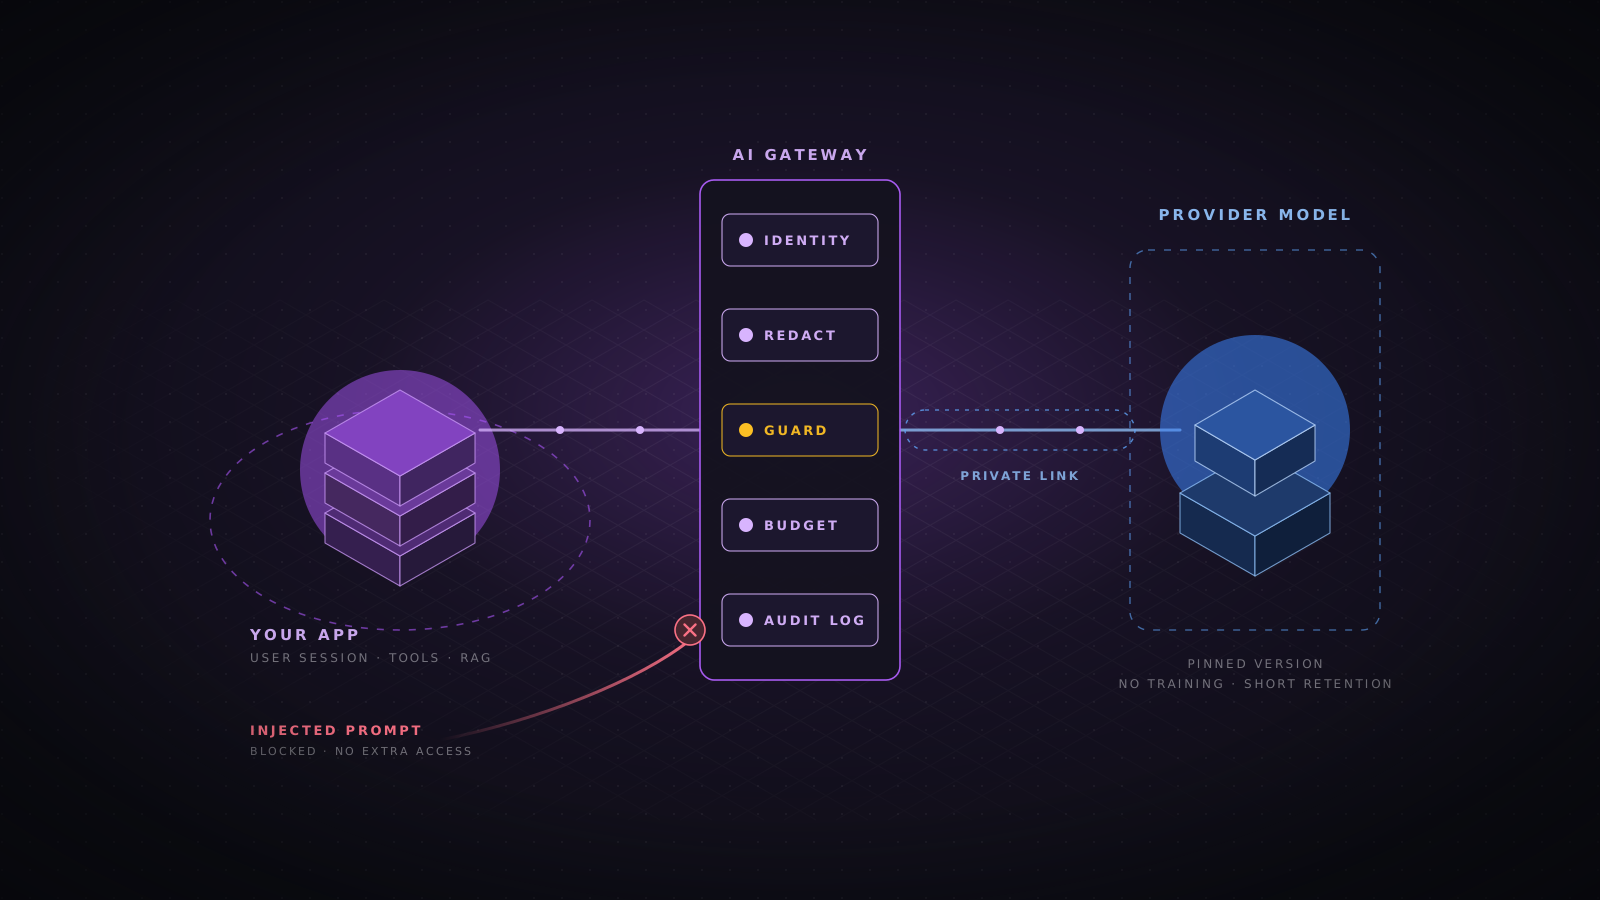
Dès que plus d’un service appelle un modèle, regroupez l’accès au fournisseur dans une passerelle IA interne unique. Les services s’authentifient auprès de la passerelle avec leur identité de charge habituelle ; seule la passerelle détient les identifiants du fournisseur. Vous pouvez la construire sur une passerelle d’API que vous exploitez déjà, ou utiliser un proxy dédié comme LiteLLM, Envoy AI Gateway ou les plugins IA de Kong. La politique vit dans la passerelle, et elle s’applique donc de la même façon à toutes les équipes.
- Identité. Chaque requête porte le service appelant et l’utilisateur final, si bien que journaux et limites sont par utilisateur, pas par clé partagée.
- Liste de modèles autorisés. Chaque service ne peut atteindre que les modèles et versions pour lesquels il est approuvé.
- Contrôles des données. Le masquage et les contrôles de classification des données s’exécutent avant que la requête ne quitte votre réseau.
- Limites. Budgets de tokens par utilisateur et par service, plafonds de taille de requête et délais d’expiration.
- Routage. Bascule vers un second fournisseur ou une autre région, et un interrupteur d’arrêt qui coupe une fonction sans déploiement.
- Journalisation. Un enregistrement d’audit cohérent par appel, quel que soit le fournisseur qui l’a servi.
Contrôler ce qui entre dans le prompt
Tout ce qui est placé dans un prompt doit être considéré comme divulgué au fournisseur et, sauf preuve du contraire, récupérable par l’utilisateur qui a envoyé la requête. La minimisation des données est le seul contrôle qui fonctionne encore si le fournisseur subit une violation, appliquez-la donc d’abord et comptez sur les contrats ensuite.
- Classer avant d’envoyer. Décidez pour chaque fonction quelles classes de données peuvent atteindre quel fournisseur. Les secrets, identifiants et numéros de carte de paiement ne doivent jamais figurer dans un prompt.
- Masquer ou pseudonymiser. Remplacez noms, e-mails, numéros de téléphone et numéros de compte par des marqueurs stables avant l’appel, et rétablissez-les dans votre propre service si la réponse en a besoin.
- Pas de secrets dans les prompts système. Supposez que le prompt système sera extrait. Il peut décrire un comportement, mais ne doit contenir ni clés, ni URL internes dont vous comptez qu’elles restent privées, ni règles d’accès que vous n’appliquez nulle part ailleurs.
- Réduire le contexte. Envoyez les quelques champs dont la tâche a besoin, pas la fiche client entière ni le fichier entier.
from presidio_analyzer import AnalyzerEngine
from presidio_anonymizer import AnonymizerEngine
from presidio_anonymizer.entities import OperatorConfig

analyzer = AnalyzerEngine()
anonymizer = AnonymizerEngine()
ENTITIES = ["PERSON", "EMAIL_ADDRESS", "PHONE_NUMBER", "IBAN_CODE", "CREDIT_CARD"]

def redact(text: str) -> str:
    findings = analyzer.analyze(text=text, entities=ENTITIES, language="en")
    return anonymizer.anonymize(
        text=text,
        analyzer_results=findings,
        operators={"DEFAULT": OperatorConfig("replace", {"new_value": "<REDACTED>"})},
    ).text
La détection par motifs et par entités nommées laisse passer des choses, surtout dans le texte libre et dans les langues pour lesquelles le modèle n’a pas été réglé. Utilisez-la comme filet de sécurité en plus de la minimisation, mesurez son rappel sur un échantillon de vos propres données, et bloquez la requête plutôt que de la laisser passer en silence quand le détecteur échoue.
La recherche doit respecter les permissions de l’utilisateur
La génération augmentée par recherche (RAG) est la voie la plus courante de fuite de données entre utilisateurs. La base vectorielle contient des fragments de tous les documents, la recherche par similarité trouve les plus proches, et le modèle résume volontiers un document que l’utilisateur n’a jamais eu le droit d’ouvrir. Le modèle ne peut pas appliquer de contrôle d’accès. Votre requête de recherche doit le faire.
Stockez le client et la liste d’accès avec chaque fragment, prenez l’identité de l’utilisateur dans la session authentifiée et filtrez dans la requête avant le classement. Ne filtrez jamais après le retour des meilleurs résultats, car cela renvoie moins de résultats et fuit encore par les temps de réponse et les décomptes. Ne laissez jamais le modèle choisir les valeurs du filtre.
-- $1 tenant_id and $2 group ids come from the verified session, never from the prompt
SELECT id, document_id, body
FROM document_chunks
WHERE tenant_id = $1
  AND allowed_groups && $2::text[]
  AND deleted_at IS NULL
ORDER BY embedding <=> $3::vector
LIMIT 8;
Gardez l’index synchronisé avec le système source. Quand un document est supprimé ou que son partage change, les fragments et leurs listes d’accès doivent changer aussi, sinon la recherche devient un moyen de lire des données révoquées. Les embeddings sont dérivés du texte source et peuvent être partiellement inversés, appliquez donc à la base vectorielle les mêmes règles de classification, de chiffrement et de rétention qu’aux documents eux-mêmes.
L’injection de prompt est un problème d’autorisation
Un modèle de langage lit les instructions et les données dans le même canal, si bien qu’un texte dans un e-mail, une page web, un PDF ou un ticket de support peut supplanter ce que vous lui avez demandé. L’injection directe vient de l’utilisateur qui tape dans votre application. L’injection indirecte vient du contenu que le modèle lit pendant son travail, et c’est la plus dangereuse, car l’attaquant n’a pas besoin de compte.
Aucun filtre n’arrête l’injection de façon fiable. Les classificateurs et les modèles de garde détectent les motifs connus et augmentent le coût d’une attaque, et vous devez les utiliser, mais partez du principe qu’un attaquant déterminé fera faire au modèle tout ce que ses outils permettent. Le vrai contrôle consiste à limiter ce qu’un modèle détourné peut atteindre.
Concevoir les outils pour un appelant hostile
- Agir en tant qu’utilisateur. Les outils s’exécutent avec les permissions de l’utilisateur final qui fait la requête, jamais avec un compte de service qui voit tous les clients.
- Valider chaque argument. Analysez les arguments des outils avec un schéma strict et vérifiez-les par rapport à la session, exactement comme pour une requête d’API publique.
- Garder l’identité hors du modèle. Les identifiants d’utilisateur, de client et les rôles viennent de votre serveur, pas d’arguments d’outil que le modèle remplit.
- Confirmer les effets de bord. Envoyer, payer, supprimer et partager exigent une confirmation explicite de l’humain, affichée hors de la sortie du modèle.
- Séparer lecture et écriture. Utilisez un appel de modèle ou un agent distinct et plus restreint pour les tâches qui lisent du contenu non fiable, sans outil qui écrit ou envoie.
import { z } from 'zod';

const RefundArgs = z.object({
  orderId: z.string().regex(/^ord_[a-z0-9]{12}$/),
  amountCents: z.number().int().positive().max(50_000),
}).strict();

export async function handleRefundTool(raw: unknown, session: Session): Promise<ToolResult> {
  const args = RefundArgs.parse(raw);
  const order = await orders.findForCustomer(args.orderId, session.customerId);
  if (!order) return { error: 'Order not found' };
  if (args.amountCents > order.refundableCents) return { error: 'Amount exceeds refundable total' };
  return { pendingConfirmation: await confirmations.create(session.userId, 'refund', args) };
}Traiter la sortie du modèle comme une entrée non fiable
La sortie du modèle est un texte produit sous l’influence de quiconque a écrit l’entrée. Traitez-la comme un champ de formulaire envoyé par un visiteur anonyme. La plupart des bugs graves d’IA hébergée observés en pratique étaient des bugs web ordinaires avec un modèle au milieu.
- Encoder avant le rendu. Affichez la sortie comme du texte, ou passez le Markdown dans un assainisseur avec liste d’autorisation. Ne l’insérez jamais en HTML brut.
- Bloquer l’exfiltration par images et liens. Une image Markdown qui pointe vers le serveur d’un attaquant, avec des secrets dans la chaîne de requête, envoie des données dès qu’elle s’affiche. Restreignez img-src dans votre Content Security Policy et réécrivez ou supprimez les liens vers des domaines inconnus.
- Ne jamais l’exécuter directement. Ne passez pas la sortie à eval, à un shell, à une chaîne SQL ou à un moteur de templates. Si le modèle écrit des requêtes, exécutez-les en lecture seule, paramétrées, avec une limite de lignes et les permissions propres à l’utilisateur.
- Valider la sortie structurée. Quand vous demandez du JSON, validez-le contre un schéma et rejetez ce qui ne correspond pas, même si le fournisseur propose un mode de sortie structurée.
Content-Security-Policy: default-src 'self';
  script-src 'self' 'nonce-r4nd0m';
  img-src 'self' https://cdn.example.com;
  connect-src 'self';
  frame-ancestors 'none';
  base-uri 'none';
form-action 'self'Limites de débit, budgets et déni de portefeuille
Chaque appel à un modèle hébergé coûte de l’argent, et une fonction d’IA publique est un robinet ouvert. Des attaquants automatisent les offres gratuites pour revendre l’accès, et une seule boucle défectueuse dans un agent peut dépenser un mois de budget en une heure. Les limites de débit du fournisseur protègent le fournisseur, pas vous, fixez donc vos propres limites en dessous.
- Plafonner la taille d’entrée. Rejetez les requêtes au-delà d’un nombre fixe de tokens ou de caractères avant qu’elles n’atteignent la passerelle.
- Toujours fixer le maximum de tokens en sortie. Choisissez une valeur par fonction au lieu de vous fier à la valeur par défaut du modèle.
- Budget par utilisateur. Suivez les tokens par utilisateur, par jour et par minute, et renvoyez une erreur claire quand le budget est épuisé.
- Borner les boucles d’agent. Limitez les appels d’outils et les tours de modèle par tâche, et arrêtez en cas d’appels identiques répétés.
- Alerter sur les dépenses. Fixez des limites de dépenses par projet chez le fournisseur et alertez sur le coût horaire, pas seulement sur la facture mensuelle.
const DAILY_TOKEN_BUDGET = 200_000;
const DAY_SECONDS = 86_400;

export async function chargeTokens(userId: string, tokens: number): Promise<boolean> {
  const key = 'llm:budget:' + userId + ':' + new Date().toISOString().slice(0, 10);
  const used = await redis.incrby(key, tokens);
  if (used === tokens) await redis.expire(key, DAY_SECONDS);
  return used <= DAILY_TOKEN_BUDGET;
}Journaliser assez pour enquêter, pas assez pour fuir
Après un incident, vous devez répondre à deux questions : qui a envoyé quoi, et qu’a fait le modèle en conséquence. Les prompts et réponses complets répondent aux deux, mais ils sont aussi une deuxième copie de tout ce que les utilisateurs ont saisi de sensible. Journalisez les métadonnées partout, et ne conservez le contenu complet que dans un stockage restreint, avec une rétention courte et sa propre revue d’accès.
{
  "ts": "2026-11-03T09:14:22.481Z",
  "request_id": "req_7f3c9a",
  "service": "support-assistant",
  "user_id": "u_18842",
  "tenant_id": "t_311",
  "provider": "bedrock",
  "model": "anthropic.claude-sonnet-4-5-20250929-v1:0",
  "region": "eu-west-1",
  "input_tokens": 1834,
  "output_tokens": 412,
  "latency_ms": 2210,
  "redactions": 3,
  "guard_verdict": "allow",
  "tool_calls": [{ "name": "lookup_order", "status": "ok" }],
  "prompt_sha256": "9b1e0f6c...",
  "content_ref": "s3://ai-audit-restricted/2026/11/03/req_7f3c9a.json"
}
Envoyez ces enregistrements et les journaux d’audit du fournisseur dans votre SIEM. Parmi les détections utiles : une clé utilisée depuis un réseau ou une région inconnus, un bond soudain des tokens par utilisateur, de nombreux blocages du modèle de garde pour un même compte, des appels d’outils qui échouent aux contrôles d’autorisation, des valeurs de modèle ou de région hors de votre liste autorisée, et des changements du plan de contrôle comme de nouvelles clés, une journalisation désactivée ou de nouveaux points de terminaison privés.
Figer les versions et tester avant chaque changement de modèle
Un modèle est une dépendance qui peut changer sous vos pieds. Des alias comme latest passent à de nouvelles versions, les anciennes versions sont retirées selon un calendrier publié, et le comportement de sécurité diffère d’une version à l’autre. Figez des versions de modèle datées dans la configuration, suivez les dates de retrait, et traitez une mise à niveau de modèle comme une mise à niveau majeure de bibliothèque, avec des tests.
Gardez une suite d’évaluation de sécurité à côté de vos évaluations de qualité : charges d’injection connues contre votre vrai prompt système et vos outils, tentatives d’extraction du prompt système, sondes de recherche entre clients, et requêtes qui doivent être refusées. Exécutez-la en CI à chaque changement de prompt, d’outil ou de modèle. Des outils open source comme promptfoo et garak peuvent générer et noter beaucoup de ces attaques.
# promptfoo: generate and run attacks against your app as configured in promptfooconfig.yaml
npx promptfoo@latest redteam run --output redteam-results.json

# garak: probe a model endpoint for prompt injection and data leakage
python -m garak --model_type openai --model_name gpt-4o-mini --probes promptinject,leakreplay
Appliquez aussi à la pile IA l’hygiène habituelle de la chaîne d’approvisionnement. Figez les versions des SDK et des frameworks d’agents, examinez les serveurs MCP et les plugins avant de les connecter, car chacun est du code qui s’exécute avec l’accès que vous lui donnez, et incluez-les dans votre analyse des dépendances.
Quand une clé fuit ou que le fournisseur passe une mauvaise journée
Écrivez le runbook avant d’en avoir besoin. Une clé de modèle divulguée est généralement découverte par un pic de facture ou un avis d’abus du fournisseur, et à ce stade elle a souvent été partagée sur des forums qui revendent des accès volés. Dans la première heure, la vitesse compte plus que la cause racine.
- Révoquer d’abord. Désactivez la clé ou détachez la politique du rôle, puis émettez un nouvel identifiant via votre gestionnaire de secrets. N’attendez pas la fin de l’enquête.
- Mesurer l’exposition. Récupérez les journaux d’usage et d’audit du fournisseur pour la clé : adresses sources, modèles appelés, volume de tokens, et tout accès aux fichiers stockés, aux modèles affinés ou aux sorties de lots.
- Vérifier le compte. Cherchez les nouvelles clés, membres, projets, webhooks ou réglages de rétention et de journalisation modifiés avec l’accès volé.
- Trouver la source. Cherchez la clé dans les dépôts, les journaux de CI, les images de conteneurs, les bundles clients et les rapports de plantage, et corrigez le chemin par lequel elle a fui.
- Contenir les dépenses. Abaissez les limites de dépenses du projet et demandez au fournisseur des crédits pour usage frauduleux, avec votre chronologie et vos preuves prêtes.
- Évaluer l’impact sur les données. Si des prompts, fichiers ou sorties stockés étaient accessibles, traitez l’événement comme une possible violation de données personnelles et associez votre équipe vie privée aux obligations de notification.
Pour les pannes ou violations chez le fournisseur, les contrôles sont ceux que vous avez construits plus tôt. Une passerelle avec interrupteur d’arrêt permet de couper une fonction ou de passer à un second fournisseur en quelques minutes. La minimisation des données limite ce qu’une violation chez le fournisseur peut exposer. Un inventaire des systèmes vous dit quelles fonctions et quelles données sont touchées quand le fournisseur publie son avis.
Correspondance des contrôles avec l’OWASP LLM Top 10
| Risque | Contrôles principaux |
|---|---|
| LLM01 Injection de prompt | Outils à moindre privilège, confirmation par l’utilisateur, agents séparés pour lecture et écriture |
| LLM02 Divulgation d’informations sensibles | Classification des données, masquage, autorisation de la recherche, conditions de rétention du fournisseur |
| LLM03 Chaîne d’approvisionnement | Versions de modèles et de SDK figées, plugins et serveurs MCP examinés |
| LLM04 Empoisonnement des données et du modèle | Sources contrôlées pour les données de recherche et d’affinage |
| LLM05 Traitement incorrect des sorties | Encodage des sorties, CSP, validation par schéma, aucune exécution |
| LLM06 Autonomie excessive | Outils exécutés en tant qu’utilisateur, validation des arguments, limites de boucles |
| LLM07 Fuite du prompt système | Aucun secret ni règle d’accès dans les prompts système |
| LLM08 Faiblesses des vecteurs et embeddings | Filtres de client et d’ACL dans la requête vectorielle |
| LLM09 Désinformation | Ancrage avec citations, évaluations, revue humaine pour les décisions |
| LLM10 Consommation illimitée | Plafonds d’entrée, maximum de tokens, budgets par utilisateur, alertes de dépenses |
Une liste de contrôle avant lancement
- Conditions consignées. Fournisseur, version du modèle, région, usage pour l’entraînement et rétention sont confirmés par écrit et stockés dans l’inventaire des systèmes.
- Aucune clé côté client. Navigateurs et applications mobiles n’appellent que votre backend, et les identifiants du fournisseur vivent dans la passerelle ou en identité de charge.
- Chemin privé. Le trafic passe par un point de terminaison privé, ou par un proxy de sortie qui n’autorise que les hôtes de fournisseurs approuvés.
- Données minimales. Les prompts ne portent que les champs dont la tâche a besoin, avec un masquage testé sur des échantillons réels.
- Recherche autorisée. Les requêtes vectorielles filtrent par client et par liste d’accès issus de la session.
- Outils encadrés. Chaque outil s’exécute en tant qu’utilisateur, valide ses arguments et exige une confirmation pour les effets de bord.
- Sortie maîtrisée. La sortie est encodée, liens et images sont restreints, et rien n’est exécuté.
- Limites fixées. Plafonds d’entrée, maximum de tokens, budgets par utilisateur, limites de boucles et alertes de dépenses sont en place.
- Journaux acheminés. Les enregistrements de la passerelle et les journaux d’audit du fournisseur arrivent dans le SIEM, le contenu complet étant conservé à part.
- Tests en CI. La suite d’évaluation de sécurité s’exécute à chaque changement de prompt, d’outil et de modèle.
- Runbook prêt. La révocation de clé, l’interrupteur d’arrêt et la bascule de fournisseur ont été testés au moins une fois.
Conclusion
Utiliser un modèle hébergé transfère au fournisseur le travail d’infrastructure le plus difficile, mais pas la sécurité de votre application. Le fournisseur décide de la manière dont le modèle s’exécute. Vous décidez qui peut l’appeler, quelles données il voit, ce qu’il a le droit de faire et ce qu’il advient de sa réponse. Traitez le modèle comme un composant puissant et non fiable derrière une passerelle que vous contrôlez, ne lui donnez pas plus d’accès que l’utilisateur en face de lui, et gardez les journaux pour le prouver. Ce sont des contrôles d’ingénierie ordinaires, et ils tiennent même quand le modèle ne tient pas.
Sources
- OWASP Gen AI Security Project, Top 10 for LLM Applications 2025.
- NIST AI 600-1, Artificial Intelligence Risk Management Framework: Generative AI Profile (juillet 2024).
- MITRE ATLAS, Adversarial Threat Landscape for Artificial Intelligence Systems.
- Simon Willison, « The lethal trifecta for AI agents: private data, untrusted content, and external communication » (juin 2025).
- Documentation AWS : sécurité d’Amazon Bedrock, points de terminaison VPC d’interface et journalisation des invocations de modèle.
- Microsoft Learn : confidentialité des données Azure OpenAI, identité managée et désactivation de l’authentification locale.
- Documentation Google Cloud : VPC Service Controls pour Vertex AI et gouvernance des données.
- Documentation des projets Microsoft Presidio, promptfoo et NVIDIA garak.
- Sécurité de l’IA
- LLM
- Injection de prompt
- OWASP LLM Top 10
- Amazon Bedrock
- Azure OpenAI
- Vertex AI
- RAG
- Passerelle IA
- Protection des données