Sommaire
Introduction
Tout contrôle de sécurité finit par échouer. Les pare-feu sont mal configurés, les mots de passe sont volés par phishing et une faille zero-day apparaît dans la seule bibliothèque que tout le monde avait oubliée. La défense en profondeur l’accepte et s’organise en conséquence : au lieu de tout miser sur une seule barrière, vous placez plusieurs contrôles indépendants entre l’attaquant et ce qui compte, pour qu’une défaillance reste un incident et ne devienne pas une compromission.
L’illusion du mur unique
De nombreuses organisations fonctionnent encore selon le modèle de la « coquille dure et du centre mou » : un périmètre solide et une confiance implicite à l’intérieur. Le problème est que ce périmètre a disparu. Le personnel travaille à domicile, les charges tournent dans plusieurs clouds et les outils SaaS détiennent les données les plus sensibles. Une fois l’attaquant entré, via un jeton de session volé, un boîtier VPN vulnérable ou un fournisseur compromis, un réseau interne plat le laisse circuler librement.
La défense en profondeur remplace la question « comment empêcher les attaquants d’entrer ? » par une question plus utile : « quand un attaquant entre, combien d’autres choses doivent mal tourner avant qu’il atteigne nos données ? »
Les couches qui comptent
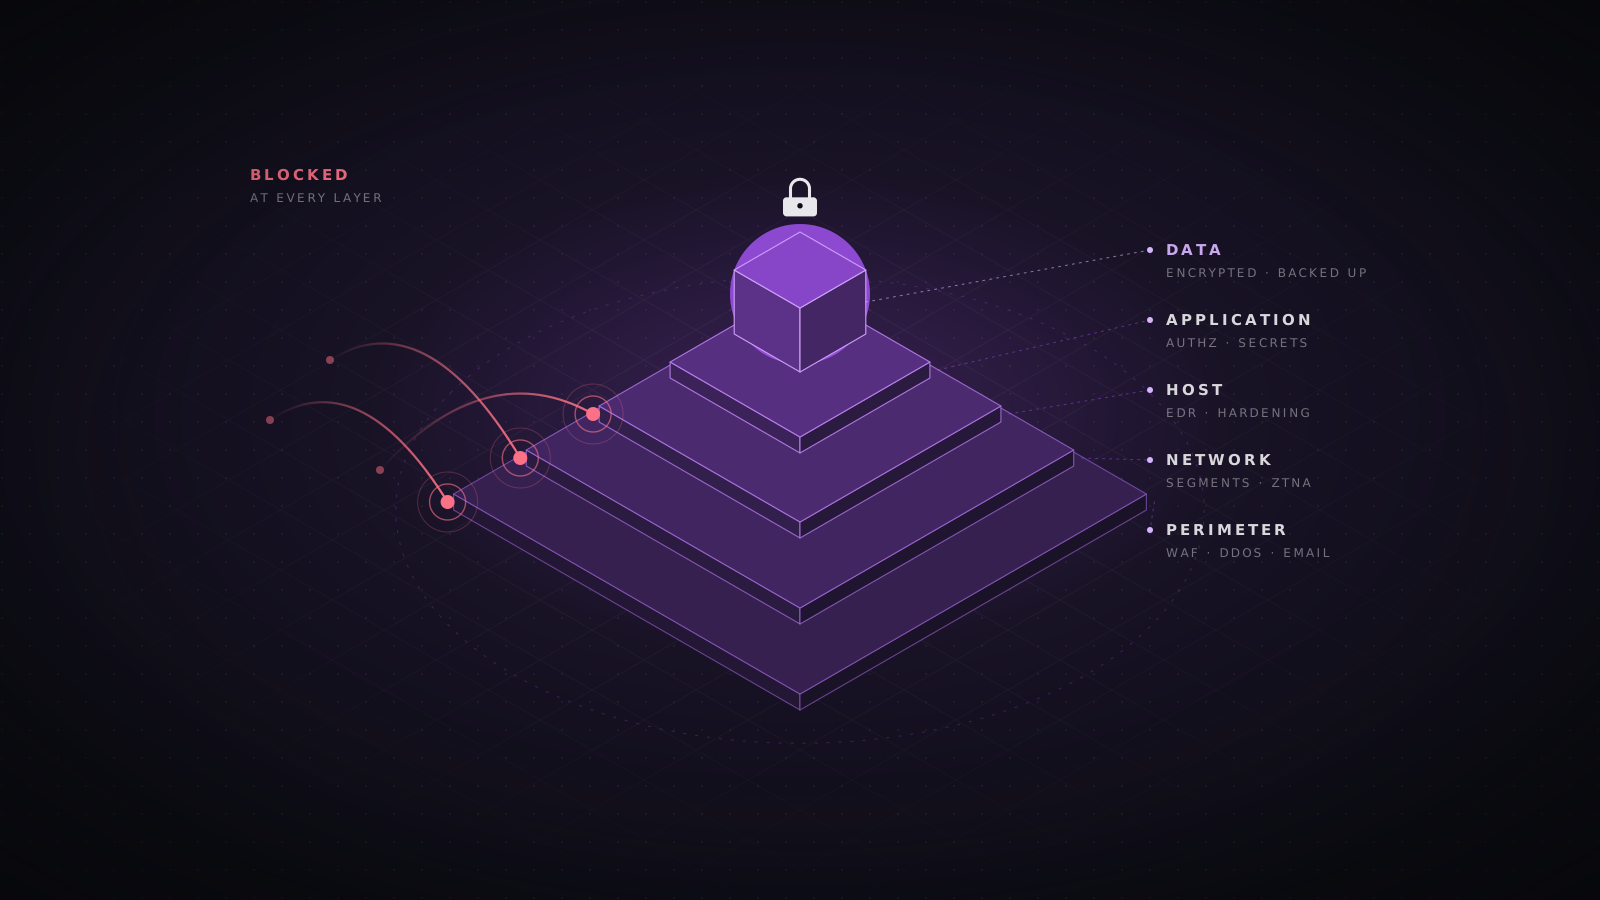
Il n’existe pas de liste officielle, mais une pile moderne a généralement besoin de contrôles à chacun de ces niveaux. L’objectif n’est pas d’acheter un produit par couche, mais de s’assurer qu’aucune couche ne porte seule toute la charge.
Identité
L’identité est désormais le premier périmètre. Une authentification multifacteur résistante au phishing (clés de sécurité FIDO2 ou passkeys), des sessions courtes et des rôles de moindre privilège arrêtent les intrusions réelles mieux que presque n’importe quel contrôle réseau. Traitez les identités d’administration comme un niveau séparé et étroitement protégé.
Réseau
Segmentez selon la sensibilité, pas selon la commodité. La production ne doit pas être accessible depuis le Wi-Fi du bureau, et un serveur web compromis ne doit pas pouvoir ouvrir de connexion vers la base de données d’un service sans rapport. Des règles de sortie refusant tout par défaut neutralisent discrètement une grande partie des techniques de commande et contrôle et d’exfiltration.
Postes et hôtes
Durcissez les images, supprimez ce qui ne sert pas, appliquez les correctifs selon un calendrier lié à l’exploitabilité et déployez une détection et réponse que quelqu’un surveille vraiment. Sur les serveurs, l’infrastructure immuable et les images de base minimales réduisent ce dont un attaquant peut tirer parti.
Application
Validez les entrées à chaque frontière, paramétrez chaque requête, appliquez l’autorisation côté serveur pour chaque objet et gardez les dépendances à jour. La revue de sécurité et les tests automatisés dans le pipeline éliminent des catégories entières de bugs avant la livraison.
Données
Chiffrez au repos et en transit, mais demandez-vous aussi qui peut lire les données en clair. Classez les données, gardez les plus sensibles dans des dépôts séparés avec des clés séparées, et rendez les sauvegardes immuables et hors ligne pour que les rançongiciels ne puissent pas les atteindre.
Concevoir des couches qui échouent indépendamment
Les couches n’apportent de la profondeur que si elles ne partagent pas le même mode de défaillance. Cinq contrôles qui font tous confiance à la même session d’authentification unique n’en font, en pratique, qu’un seul. Lors d’une revue de conception, suivez une attaque réaliste et vérifiez que chaque couche l’arrêterait pour une raison différente.
- Séparez les identifiants qui protègent chaque couche : un jeton d’administration de la console cloud ne doit pas aussi ouvrir les bases de données de production.
- Évitez de mettre un seul éditeur ou un seul agent sur chaque couche, pour qu’un bug ou une panne ne puisse pas toutes les désactiver.
- Préférez les contrôles qui se ferment en cas de panne : si le service de politiques est indisponible, l’accès est refusé et non accordé.
- Supposez la compromission à chaque revue de conception : partez de « ce serveur est compromis » et demandez-vous ce qui tient encore.
La détection est aussi une couche
La prévention fait gagner du temps ; la détection et la réponse décident de l’usage de ce temps. Centralisez les journaux d’identité, des postes, des plans de contrôle cloud et des applications, et alertez sur les comportements plutôt que sur les seules signatures. Relier vos détections au cadre MITRE ATT&CK est un moyen concret de voir quelles techniques vous remarqueriez réellement et lesquelles passeraient inaperçues.
Mesurez-le. Le délai moyen de détection et le délai moyen de confinement sont les chiffres qui montrent si vos couches travaillent ensemble ou existent simplement côte à côte.
Où les équipes se trompent
- Acheter des outils au lieu de concevoir des contrôles, et se retrouver avec des produits qui se recoupent et partagent le même angle mort.
- Laisser une couche, généralement l’identité, comme point de défaillance unique pour toutes les autres.
- Ne jamais tester les couches : les contrôles qui n’ont jamais subi de test d’intrusion ou de Red Team ne fonctionnent souvent pas comme prévu.
- Produire des alertes que personne ne trie, ce qui transforme une couche de détection en bruit.
Une liste de contrôle pour commencer
- Inventoriez vos actifs critiques et les chemins qui y mènent.
- Déployez une MFA résistante au phishing, en commençant par les administrateurs et les accès à distance.
- Séparez la production des réseaux d’entreprise et limitez le trafic sortant.
- Corrigez d’abord les systèmes exposés à Internet, en priorité les vulnérabilités connues pour être exploitées.
- Rendez les sauvegardes immuables et répétez une restauration.
- Centralisez les journaux et convenez de qui répond, et à quelle vitesse, lorsqu’une alerte se déclenche.
- Validez l’ensemble par un test offensif au moins une fois par an.
Conclusion
La défense en profondeur ne vise pas la perfection d’une seule couche. Elle vise à garantir que, lorsqu’un élément échoue, et cela arrivera, la défaillance soit contenue, remarquée et récupérable.
- Défense en profondeur
- Architecture de sécurité
- Supposer la compromission



